개요
운영 중인 JVM 애플리케이션에서 힙 사용량은 정상이었지만 RSS가 계속 늘어
재시작이 반복됐다. 조사 결과, 애플리케이션이 free로 해제한 메모리를
glibc가 OS에 반환하지 않고 보관하고 있었다.
이 글은 원인을 찾고 설정을 바꿔 확인한 과정을 담았다. 뒤에서는 조사에 쓴 도구와 메모리 할당자의 동작을 설명한다.
상황
힙 사용량은 약 2GB였지만 RSS는 3.7GB까지 늘어 컨테이너 메모리 제한인 4GB에 가까워졌다. 한 파드가 OOMKill로 재시작되면 요청이 남은 파드로 몰렸다. 요청 성공률은 유지됐지만 재시작이 반복됐다.
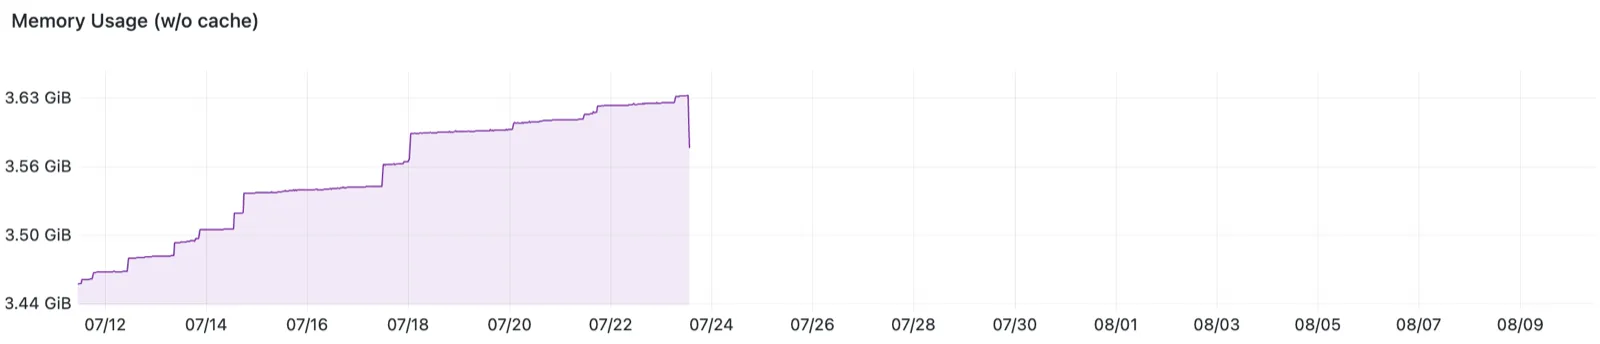
장애 당시 측정값은 다음과 같았다.
| 지표 | 측정값 | 해석 |
|---|---|---|
| 컨테이너 메모리 제한 | 4GB | 컨테이너에 설정한 메모리 상한 |
| Java 힙 | 약 2.05GB | 한 파드는 Xmx까지 커밋, 설정 범위 이내 |
| NMT committed | 약 2.5GB | JVM이 추적하는 전체 커밋 메모리 |
| 프로세스 RSS | 약 3.7GB | 메모리 제한의 약 93% |
| RSS와 NMT committed 차이 | 약 1.2GB | NMT가 추적하지 않는 메모리도 조사할 필요 |
이 글에서 ‘차이’는 RSS에서 NMT committed를 뺀 값이다. 두 지표는 측정 기준이 달라 이 값을 특정 메모리 영역의 사용량으로 볼 수는 없다. 자세한 내용은 RSS와 NMT의 측정 기준에서 설명한다.
먼저 NIO 임시 다이렉트 버퍼가 쌓이는 문제를 찾았다.
MultipartFile#getBytes()로 PDF를 읽을 때 이 버퍼를 만들고 있었다.
PdfService.chat()
 └ StandardMultipartFile.getBytes()
   └ ChannelInputStream.readAllBytes()
     └ FileChannelImpl.read(힙 버퍼)
       └ IOUtil.read
         └ Util.getTemporaryDirectBuffer
           └ Bits.reserveMemory
이 경로에서는 힙 배열로 파일을 읽어도 커널 I/O에 같은 크기의 임시 다이렉트
버퍼를 사용한다. 사용이 끝난 버퍼는 스레드별 캐시에 남는다. 각 스레드가
더 큰 파일을 읽을 때마다 캐시도 커져, 스레드 수 × 각 스레드가 읽은 최대 파일 크기에 가까운 메모리가 쌓였다.
테스트에서는 MaxDirectMemorySize를 50MB로 낮춰 다이렉트 버퍼의 OOM을
재현했다. 이후 아래 설정으로 캐시에 남길 버퍼 크기를 제한했다.
-Djdk.nio.maxCachedBufferSize=262144| 제한 적용 전 | maxCachedBufferSize 적용 후 |
|---|---|
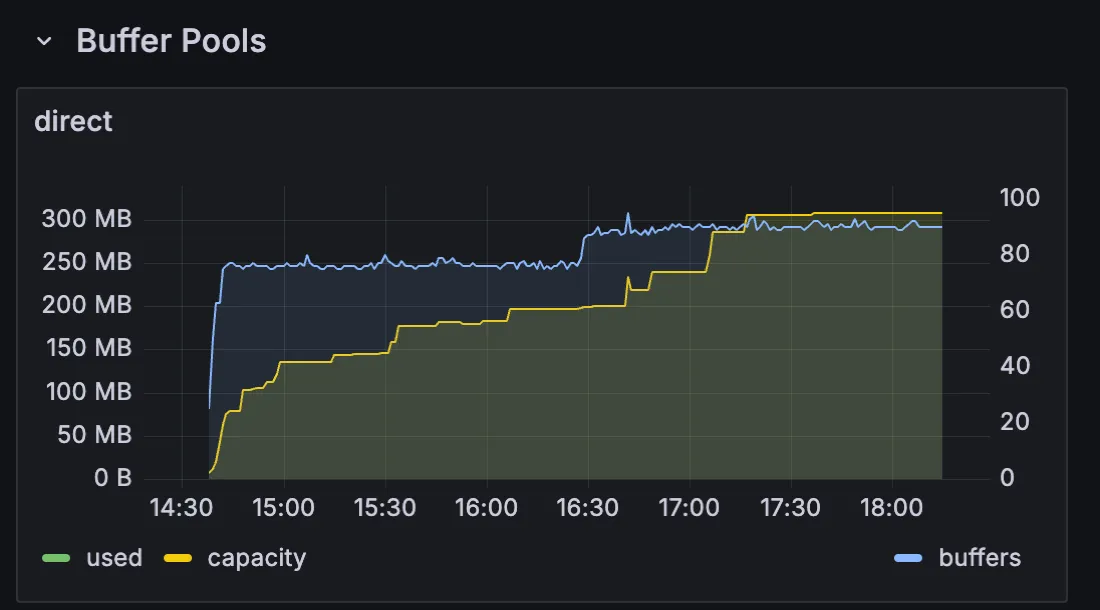 | 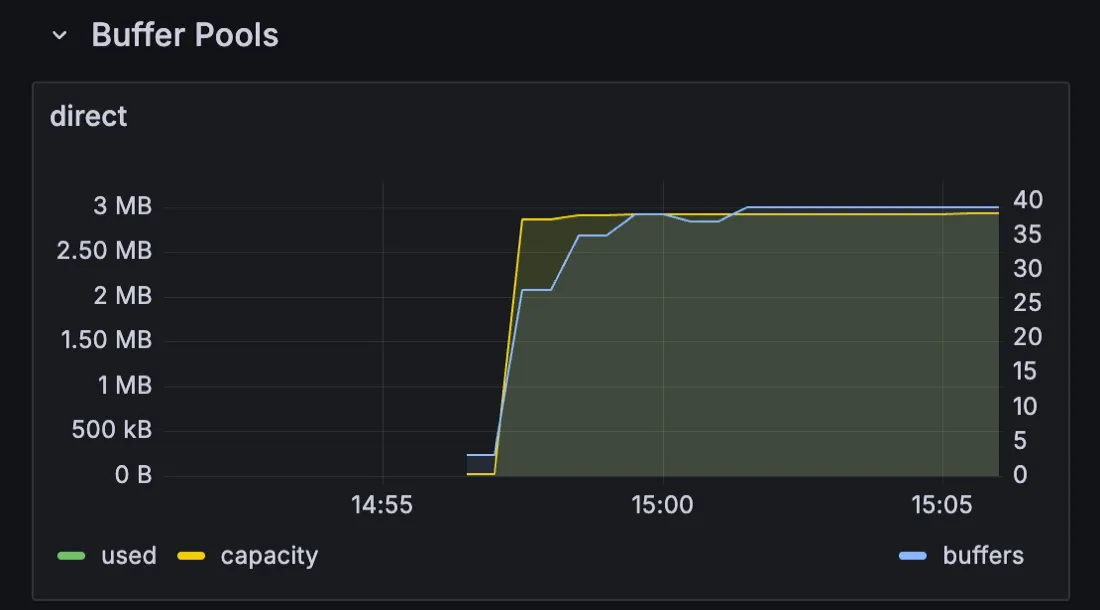 |
| 요청을 처리할수록 버퍼 용량이 300MB까지 늘어난다. | 버퍼 용량이 일정하게 유지된다. |
이 조치로 재시작 간격은 1일에서 5일로 늘었다. 컨테이너 메모리 제한도 2GB에서 4GB로 늘리자 재시작 간격은 더 길어졌다.
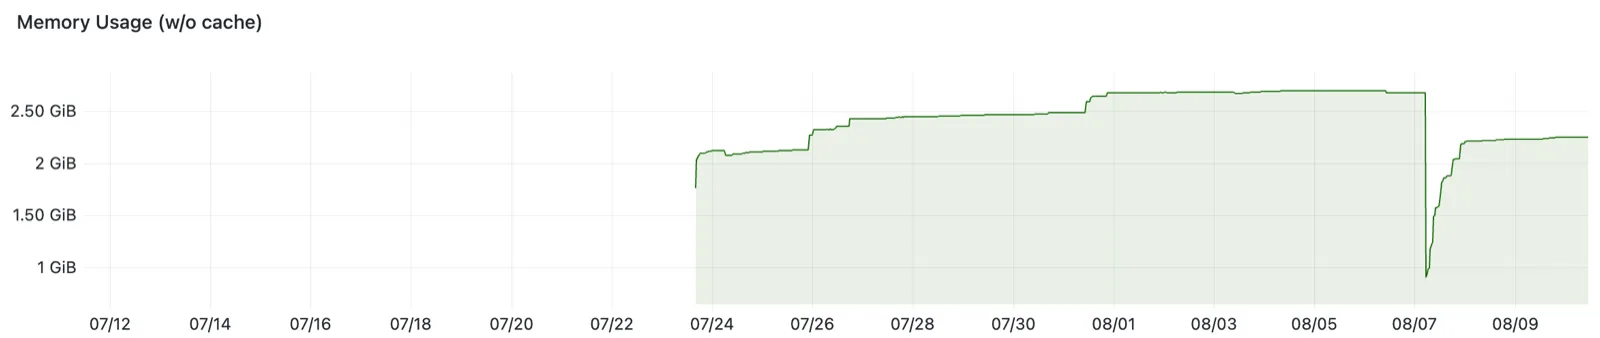
그래도 RSS는 계속 늘었고, NMT committed와 약 1.2GB 차이가 났다. 다이렉트 버퍼 외에 RSS가 늘어나는 원인을 더 찾아야 했다.
원인
NMT로 JVM 내부를 확인한 뒤, 메모리 매핑과 할당 기록을 차례로 비교했다.
프로세스 RSS
  → JVM 내부 할당 확인: NMT
  → 프로세스 메모리 매핑 확인: pmap
  → 할당과 해제 기록 확인: malloc/free 프로파일링
먼저 NMT의 baseline으로 기준점을 저장하고 부하 전후의 증가량을 비교했다.
Java Heap, Class, Thread, Code, GC, Compiler, Other 중
1.2GB 차이를 설명할 만큼 늘어난 항목은 없었다. JMX BufferPoolMXBean과
NMT Other로 확인한 다이렉트 버퍼도 약 40MB뿐이었다.
NMT 사용법에 실행 방법을 정리했다.
다음으로 부하 전후의 pmap -x 출력을 NMT detail의 주소 범위와 비교했다.
로컬 Docker 실험에서 RSS는 1,074MB 증가했다.
| 증가 영역 | 증가량 | 판정 |
|---|---|---|
| Java 힙 | +815MB | Xmx 이내 정상 증가 |
| GC·Metaspace·Code | +33MB | JVM 내부 정상 증가 |
| NMT 밖 익명 영역 | +225MB | 추가 조사 대상 |
NMT가 추적하지 않는 영역의 증가량 225MB 중 223MB는 64MB 경계에 정렬된 익명 매핑 78개에 흩어져 있었다. glibc가 여러 스레드의 메모리 할당을 처리할 때 쓰는 arena와 같은 배치였다. arena는 할당할 메모리를 관리하는 단위다.
운영 파드에서는 jcmd 1 System.trim_native_heap 전후의 매핑을 비교했다.
이 명령은 C 힙에서 반환 가능한 페이지를 OS에 반환한다.
0x7a07e8000000   65516K rw   RSS      8K    (trim 전 RSS 65,516K)
0x7a0850000000 65536K rw RSS 17,592K (trim 전 RSS 65,536K)- 첫 번째 trim: 두 파드에서 각각 207MB와 96MB 반환
- 두 번째 trim: 추가로 반환한 메모리는 거의 없음
이 결과만으로 1.2GB 차이 전체를 반환 가능한 메모리로 볼 수는 없었다. 한 파드에서 바로 반환된 메모리는 약 0.2GB였다. 나머지에는 아직 사용 중인 메모리나, 사용 중인 메모리와 해제된 메모리가 한 페이지에 섞여 반환하지 못한 영역이 있을 수 있었다. 자세한 내용은 pmap과 trim 사용법에서 설명한다.
다음으로 두 가능성을 구분해야 했다.
- 네이티브 라이브러리가 메모리를 해제하지 않아 누수가 생긴다.
- 메모리를 해제해도 glibc가 OS에 반환하지 않아 RSS가 줄지 않는다.
같은 애플리케이션 이미지에 malloc과 free 호출을 기록하는 프로파일러를
붙였다. 부하를 주는 동안 60초간 호출을 기록하고, 메모리 주소를 비교해
해제되지 않은 메모리의 양을 계산했다.
| 할당자 | 수집한 malloc 호출 | 수집한 할당량 | 해제되지 않은 양 |
|---|---|---|---|
| glibc | 873건 | 5.2MB | 0.02MB |
| jemalloc | 2,123건 | 12.4MB | 0.06MB |
수집한 표본에서 해제되지 않은 메모리는 0.1MB 미만이었다. 이 기록에서는 RSS 증가를 설명할 만한 누수를 찾지 못했다.
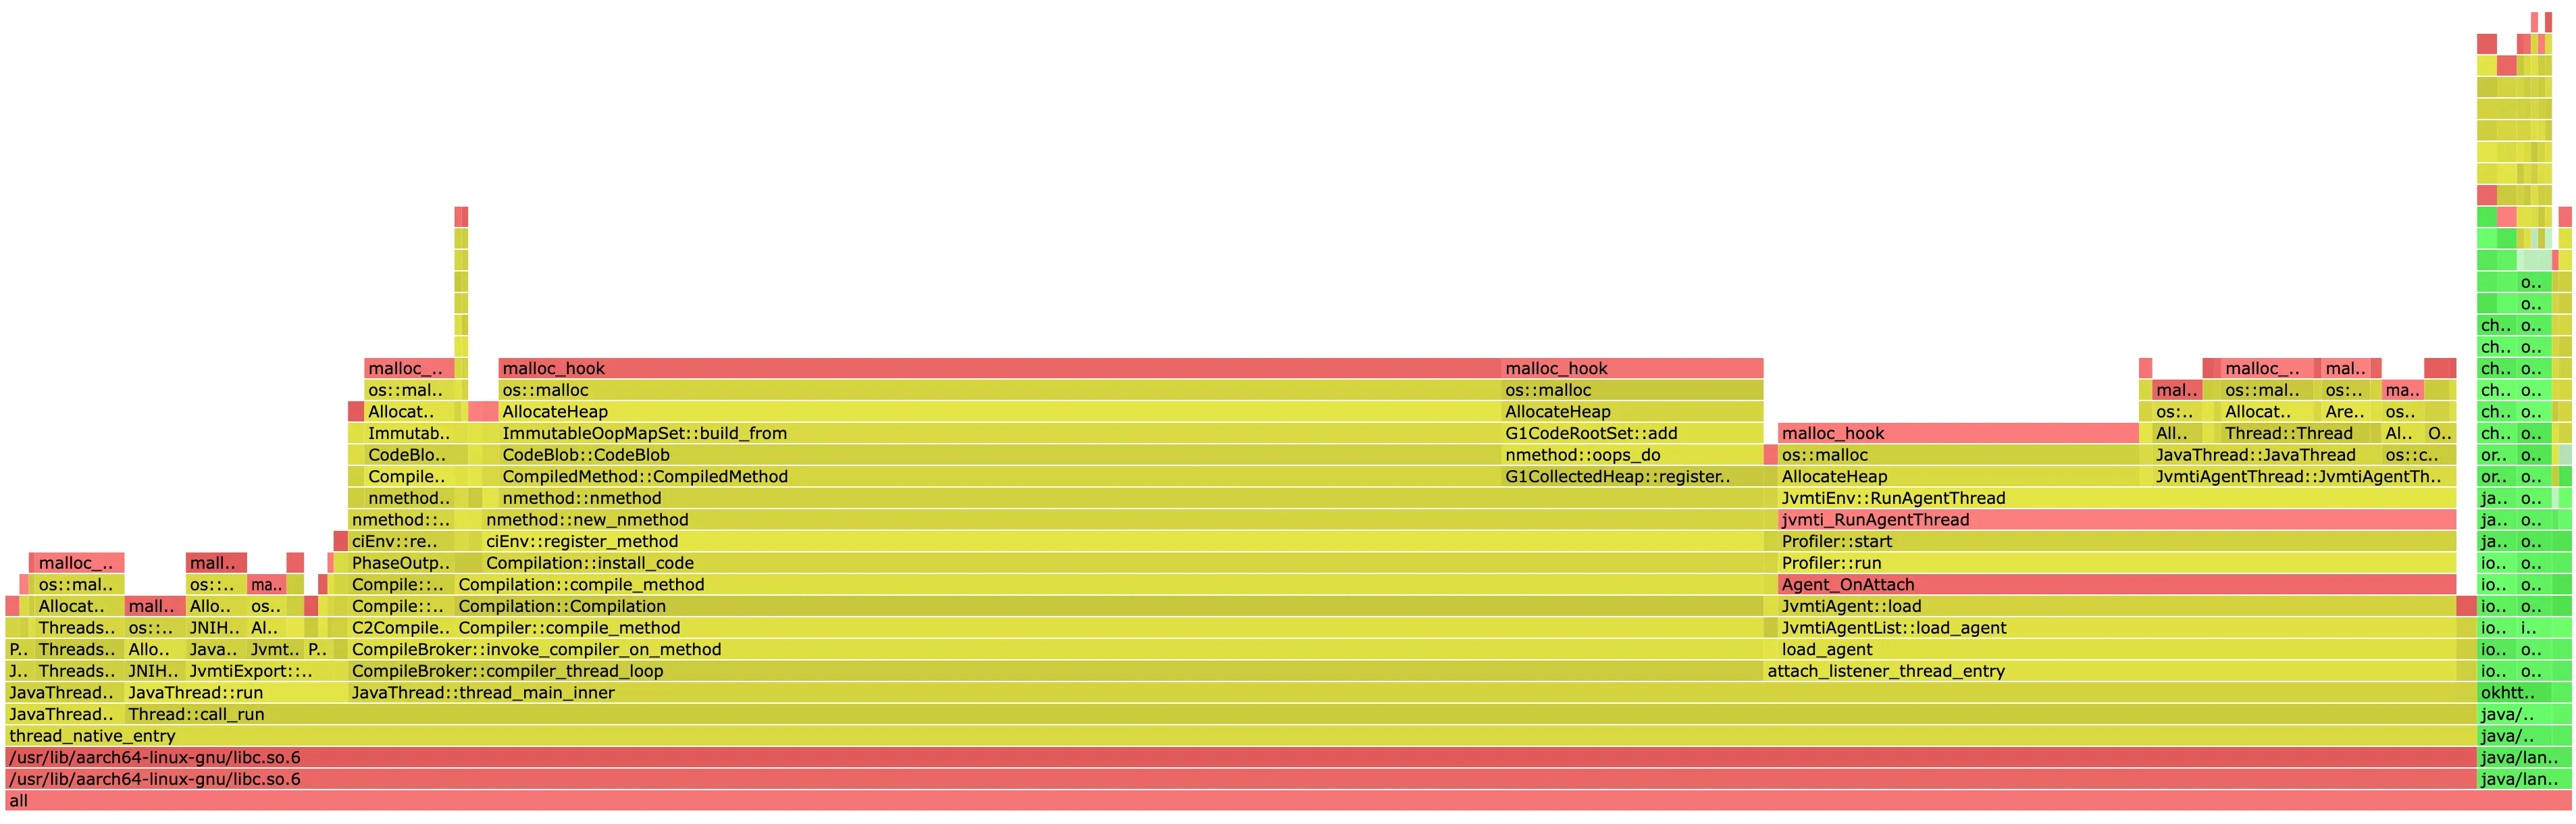
기록된 할당의 대부분은 CompileBroker에서 시작한 C2 JIT 컴파일 작업이었고,
작업이 끝난 뒤 해제됐다. 해제되지 않은 NIO 다이렉트 버퍼도 6.8KB 한 건뿐이었다.
앞서 적용한 maxCachedBufferSize 제한도 작동하고 있었다.
이후에는 glibc가 해제된 메모리를 보관하는 동작을 조사했다. 같은 부하에서 할당자만 바꿔 비교하자 glibc에서만 RSS와 NMT committed의 차이가 계속 늘었다.
문제
glibc는 해제된 메모리를 다음 할당에 재사용하려고 보관한다. free가 정상적으로
호출돼도 RSS가 줄지 않을 수 있다. 그래서 glibc 설정을 조정하는 방법과 다른
할당자로 바꾸는 방법을 비교했다. 메모리를 보관하는 이유는
glibc의 메모리 관리에서 설명한다.
먼저 arena 수를 제한하는 MALLOC_ARENA_MAX=2를 별도 실험으로 확인했다.
스레드 24개로 크기가 다른 메모리의 할당과 해제를 반복하자 RSS가 30초 만에 137MB에서 1,441MB까지 올랐다.
여기에 MALLOC_ARENA_MAX=2를 적용하자 RSS가 오히려 44% 늘었다. arena가
2개로 줄면서 한 arena에 크기가 다른 할당이 몰렸고, 단편화가 더 심해진
것으로 봤다.
이 설정이 메모리 사용량을 줄일지는 실제 애플리케이션 부하에서도 확인해야 했다.
해결
애플리케이션, 컨테이너 이미지, 메모리 제한, JVM 옵션, 부하를 같게 두고 할당자 설정만 바꿔 20분씩 측정했다. 비교한 구성은 셋이다.
# glibc 기본
기본 이미지 그대로 실행

# glibc + arena 제한
MALLOC_ARENA_MAX=2

# jemalloc 전환
LD_PRELOAD=<path-to-libjemalloc.so.2>
MALLOC_CONF=background_thread:true
jemalloc의 background_thread:true는 별도 스레드가 빈 페이지를 OS에
반환하게 한다. 첫 실험에서는 이 설정이 없을 때 부하가 멈춘 뒤에도 메모리가
반환되지 않았다. jemalloc의 메모리 반환 방식에서
glibc와의 차이를 설명한다.
결과
20분 동안 같은 부하를 줬을 때, RSS와 NMT committed의 차이는 glibc에서 계속 늘었고 jemalloc에서는 일정 범위를 유지했다.
| 지표 | glibc | jemalloc |
|---|---|---|
| 시작 시점의 차이 | 48MB | 약 240MB |
| 종료 시점의 차이 | 486MB | 약 245MB |
| 최종 RSS | 1,835MB | 1,591MB |
| 추세 | 계속 증가 | 일정 범위 유지 |
glibc의 최대 RSS는 1,881MB로 메모리 제한인 2GiB의 92%까지 늘었다. 운영에서 OOMKill이 발생하기 전처럼 메모리 제한에 가까워졌다. jemalloc은 시작 시점의 차이가 더 컸지만, 실험이 끝날 때도 약 245MB를 유지했다.
glibc를 유지하면서 arena 수만 제한한 구성도 실제 부하에서 다시 측정했다.
- glibc 기본: 차이 275MB, 부하를 반복할수록 계속 증가
MALLOC_ARENA_MAX=2: 차이 69MB, trim 설정을 더하면 31MB
앞선 별도 실험에서는 이 설정으로 RSS가 44% 늘었다. 실제 애플리케이션 부하에서는 RSS와 NMT committed의 차이가 75% 줄었다.
두 방법의 장단점은 다음과 같다.
MALLOC_ARENA_MAX=2 | jemalloc 전환 | |
|---|---|---|
| 이번 실험의 메모리 결과 | 차이 31~69MB | 약 245MB 유지 |
| 적용 난이도 | 환경변수 한 줄 | 이미지 변경과 LD_PRELOAD 필요 |
| 동시 할당 경합 | arena 공유로 증가 가능 | 다중 arena 설계로 상대적으로 유리 |
| 기본 보관 메모리 | 작음 | tcache·dirty 페이지로 큼 |
| 운영 판단에 필요한 지표 | RSS와 응답 시간 | RSS와 메모리 반환량, 이미지 안정성 |
이 실험에서는 arena 수를 제한한 glibc가 RSS와 NMT committed의 차이가 더 작았다. 다만 여러 스레드가 arena 두 개를 공유할 때 메모리 할당이 얼마나 늦어지는지는 확인하지 않았다. jemalloc은 실험 중 차이가 계속 늘지 않았다. 운영에 적용할 설정은 실제 운영 수준의 부하에서 RSS, 처리량, 응답 시간을 함께 확인한 뒤 정해야 했다.
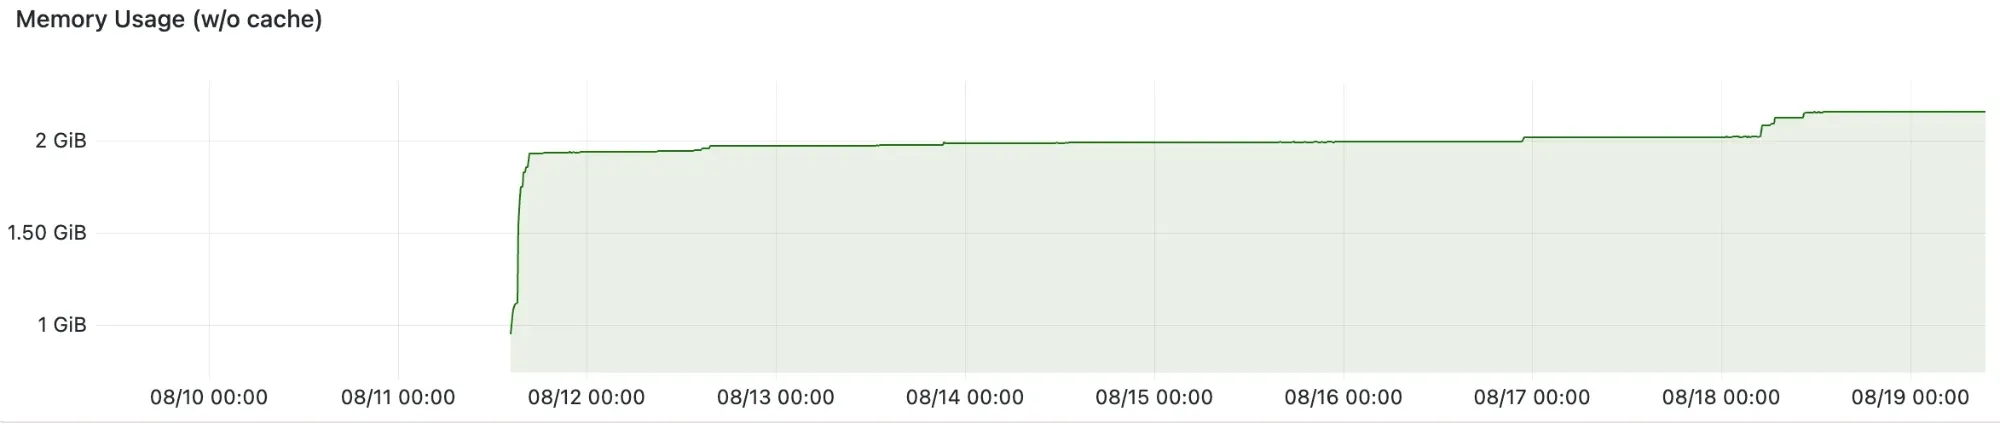
운영에는 arena 수를 제한하는 MALLOC_ARENA_MAX=4를 적용했다. 적용한 파드는
시작 직후 힙이 커진 뒤 7일간 RSS가 거의 일정했다. 8일차에 한 번 늘어난 뒤에도
다시 일정하게 유지됐다. 요청량과 응답 시간까지 확인한 과정은
8월 2주차 회고에 정리했다.
조사 도구와 메모리 관리 방식
조사에 쓴 도구의 사용법과 glibc, jemalloc의 메모리 관리 방식을 정리했다.
1. RSS와 NMT의 측정 기준
JVM 프로세스는 Java 힙 외에도 여러 영역에서 메모리를 사용한다.
프로세스 RSS
  ├─ Java 힙
  ├─ JVM 네이티브 메모리: GC, Metaspace, Code Cache, 스레드 스택, Compiler 등
  ├─ 다이렉트 버퍼
  ├─ JNI·네이티브 라이브러리의 malloc
  ├─ 할당자가 보관 중인 해제된 메모리
  └─ 공유 라이브러리와 파일 매핑
NMT(Native Memory Tracking)는 이 중 HotSpot 내부 할당을 추적한다. JNI나 외부 네이티브
라이브러리가 직접 호출한 malloc까지 모두 기록하는 도구는 아니다. 따라서
NMT committed가 낮다는 사실만으로 “네이티브 메모리는 정상”이라고 결론 내릴
수 없다.
RSS는 프로세스의 메모리 페이지 중 현재 RAM에 올라온 크기다. NMT committed는 JVM이 추적하는 커밋 메모리의 크기다. 공유 페이지, 커밋됐지만 RAM에 올라오지 않은 페이지, 할당자가 보관 중인 페이지 때문에 두 값은 다를 수 있다.
RSS - NMT committed는 사용량이 아니다두 값은 측정 기준이 달라, 빼서 얻은 차이를 특정 메모리 영역의 크기로 볼 수
없다. 같은 부하에서 차이가 계속 늘면 NMT가 추적하지 않는 영역도 조사해야 한다.
누수나 단편화가 원인인지는 pmap의 주소와 NMT detail을 비교하고,
할당과 해제 기록을 확인해야 알 수 있다.
2. NMT 사용법
NMT는 실행 중에 새로 켤 수 없으므로 프로세스를 시작할 때 활성화해야 한다.
운영에서는 우선 summary, 호출 지점까지 필요한 재현 환경에서는 detail을
선택한다.
-XX:NativeMemoryTracking=summary
-XX:NativeMemoryTracking=detail
Oracle 문서는 NMT를 켜면 성능이 약 5~10% 낮아질 수 있다고 안내한다.
운영에서 detail을 사용할 때는 성능에 미치는 영향을 확인하고 사용 기간을 정한다.
메모리가 늘어나는 원인을 찾을 때는 기준점을 저장하고 증가량을 비교한다.
jcmd 1 VM.native_memory summary scale=MB
jcmd 1 VM.native_memory baseline

# 같은 부하를 재현하거나 일정 시간 기다린 뒤
jcmd 1 VM.native_memory summary.diff scale=MB
호출 지점까지 추적해야 한다면 detail.diff를 사용한다.
jcmd 1 VM.native_memory detail.diff scale=MB3. pmap과 trim 사용법
pmap -x <pid>는 프로세스의 가상 메모리 매핑을 한 줄씩 보여준다. 매핑의
주소, 크기, RSS, dirty 페이지를 함께 표시한다. 이 값은
Linux가 매핑별 정보를 기록하는 /proc/<pid>/smaps 파일에서 가져온다.
합계만 빠르게 볼 때는 smaps_rollup을 읽는다.
pmap -x 1
grep -E 'VmRSS|VmSize|RssAnon|RssFile' /proc/1/status
cat /proc/1/smaps_rollup
64MB 경계에 정렬된 익명 매핑이 여러 개 보이면 glibc arena를 의심할 수
있다. 다만 배치만으로 원인을 확정할 수는 없다. 부하 전후 증가량과 NMT detail의
주소를 함께 비교해야 한다.
jcmd <pid> System.trim_native_heap은 C 힙에서 반환 가능한 페이지를
OS에 반환한다. trim 실행 뒤 RSS가 크게 줄면 할당자가 반환 가능한 메모리를
보관하고 있었다는 뜻이다. 두 번째 실행에서 더 줄지 않으면 아직 사용 중인
메모리나 단편화로 반환하지 못한 메모리가 남아 있는지 조사한다.
System.trim_native_heap으로 C 힙에 반환 가능한 메모리가 있는지 확인할 수 있다.
다만 사용 중인 메모리를 해제하거나 페이지 내부 단편화를 해결하지는 않는다.
지원 플랫폼과 JDK 버전을 확인하고, 테스트 환경에서 영향을 확인한 뒤 사용한다.
4. glibc가 해제된 메모리를 보관하는 방식
glibc는 free로 해제한 메모리를 바로 OS에 반환하지 않고 다음 할당에
재사용하려고 보관할 수 있다. 스레드 간 경합을 줄이려고 arena를 여러 개
만들면 arena마다 메모리를 보관한다.
스레드는 할당받은 arena를 재사용한다. 여러 스레드가 동시에 할당을 요청하면 경합을 줄이기 위해 arena를 추가로 만들 수 있다.
해제된 메모리라도 OS에 반환하지 못하는 경우가 있다. 한 페이지에 사용 중인 메모리와 해제된 메모리가 섞여 있으면 페이지 전체를 반환할 수 없다. 힙 끝에 사용 중인 메모리가 남아 힙을 줄이지 못하는 경우도 있다.
5. jemalloc의 메모리 반환 방식
jemalloc은 할당 크기에 따라 메모리를 나눠 관리하며, 작은 할당에는 slab을
사용한다. 반환 가능한 빈 페이지는 힙 끝에 모여 있지 않아도 OS에 반환할 수
있다. background_thread:true를 켜면 별도 스레드가 메모리 반환을 처리한다.
6. 네이티브 메모리 조사 순서
비슷한 문제가 다시 생기면 아래 순서로 조사한다.
1. 컨테이너와 JVM 지표를 같은 시점에 저장한다
- 컨테이너 working set과 메모리 제한
- 프로세스
VmRSS,RssAnon,RssFile - Java 힙의 committed/used
- NMT
summary - JMX Buffer Pool의 direct/mapped 사용량
- 스레드 수와 스택 크기
2. NMT의 기준점을 저장한다
정상일 때 baseline을 저장하고, 문제가 생겼을 때 summary.diff로 증가량을
확인한다. NMT 항목 중 RSS 증가를 설명할 만큼 늘어난 항목이 있으면 해당
JVM 영역부터 조사한다.
3. NMT가 설명하지 못하면 pmap으로 매핑을 확인한다
익명 매핑, 파일 매핑, 스레드 스택을 구분하고 주소 범위를 NMT detail과
비교한다. 64MB 경계에 정렬된 매핑처럼 특정 배치가 보여도 부하 전후의
증가량을 함께 확인한다.
4. trim을 실행해 반환 가능한 메모리가 있는지 확인한다
trim 실행 전후의 RSS를 비교한다. 첫 실행에서 줄어든 양과 두 번째 실행에서 추가로 줄어든 양을 확인한다. 남은 메모리는 사용 여부와 단편화를 더 조사한다.
마무리하며
처음에는 힙이 정상인데 RSS가 왜 계속 늘어나는지 알기 어려웠다. NMT와
pmap을 비교해 조사 범위를 좁히고, malloc과 free 기록으로 해제 여부를
확인하면서 원인을 찾았다. 같은 부하에서 할당자 설정을 바꿔 본 실험이
운영에 적용할 설정을 고르는 근거가 됐다.
비슷한 문제가 생기면 힙 사용량과 함께 RSS를 확인하고, 메모리가 해제됐는지와 OS에 반환됐는지를 구분해 조사하려 한다.