지난 부하테스트에서 DB 풀과 서버 CPU, 태스크 수를 조정했습니다. 같은 설정으로 30시간 soak test를 진행하며 HTTP 응답 시간과 JVM 상태를 확인했습니다.
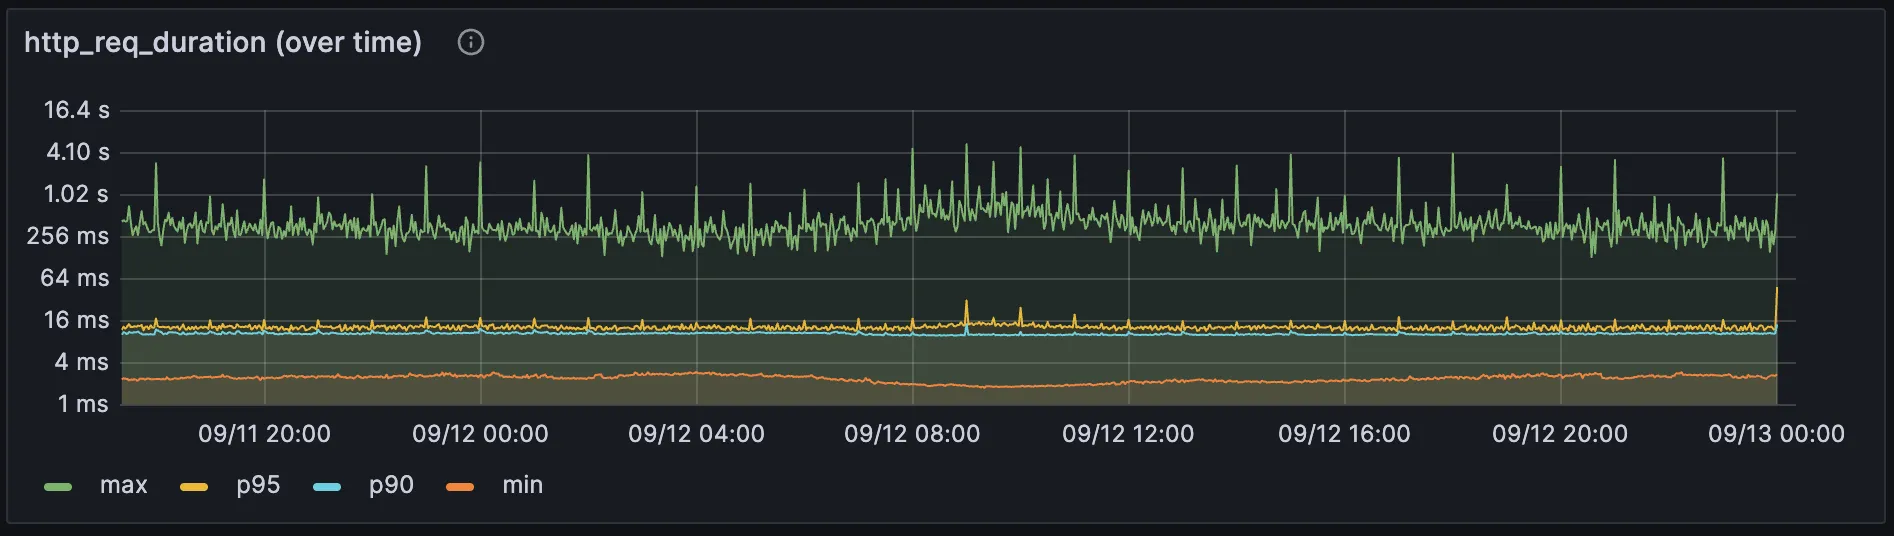
일부 요청에서 순간적인 지연이 있었지만, 그래프의 구간별 p90·p95는 대부분 16ms 아래를 유지했습니다. 30시간 동안 JVM 메모리 누수는 관찰되지 않았고, HTTP 응답 시간도 전반적으로 일정했습니다. 이를 확인하고 이번 부하테스트를 마무리했습니다.
Splunk 통계 수집 일원화
지금 겪는 문제
- 같은 통계 데이터도 API 직접 전송과 UF 파일 수집으로 수집 경로가 나뉘어 있었습니다.
- 통계 데이터마다 수집 방식도 달라 공통으로 관리하기 어려웠습니다.
VoC에 대응하기 위해 일부 기능의 인입 로그를 S3에 보관하고 있습니다. 로그마다 수집 경로와 저장 위치, 설정을 따로 관리해야 해 부담이 컸습니다. 인프라팀에서도 중간 경로가 많아 관리하기 어렵다고 했습니다.
기존 수집 방식의 예시
기존 방식 1 — API 직접 전송: 일부 서비스는 애플리케이션에서 Splunk API를 직접 호출해 통계 이벤트를 보냈습니다.
기존 방식 2 — UF 파일 수집: EC2에 EFS를 마운트하고, UF가 로그 파일을 읽어 Splunk로 보냅니다.
로그 전송을 위해 EFS·EC2·UF를 관리해야 했고, EFS와 EC2의 사용 비용도 들었습니다.
신규 방식 — FireLens
수집 방식을 일원화하기 위해 ECS에서 FireLens PoC를 진행하고 있습니다. 콘솔 로그 중 logtype=splunk인 로그는 Splunk로, 나머지는 기존 CloudWatch로 보냅니다.
VoC 대응용 인입 로그는 logtype=s3로 구분해 S3로 보내는 경로를 추가하려고 합니다.
CloudWatch 유지
기존 서비스의 동작을 유지하면서 새로운 통계 수집 방식을 적용하려고 합니다. 일반 로그는 계속 CloudWatch로 보내고, 통계 이벤트는 Splunk로 보내기로 했습니다.
Logback은 로그의 출력 경로를 정하고, Fluent Bit은 콘솔 로그를 목적지별로 나눠 보냅니다. OTEL 전송 경로는 따로 유지합니다.
Logback 출력 설정
console-log.xml과 otel-log.xml에서 appender를 정의하고, click-log.xml과 transaction-log.xml에서 로거별 출력 경로를 정했습니다. root 로거에는 CONSOLE과 OTEL을 연결했습니다.
통계 이벤트용 로거에는 CONSOLE_RAW만 연결했습니다. additivity="false"로 상위 로거로의 전달을 끊어 콘솔 중복 출력과 OTEL 전송을 막았습니다.
click-log.xml의 설정입니다.
<included>
    <logger name="CLICK_LOGGER" level="INFO" additivity="false">
        <appender-ref ref="CONSOLE_RAW"/>
    </logger>
</included>click-log.xml
PoC에서는 통계 이벤트가 JSON 한 줄로 출력되는지, logtype이 최상위 필드에 포함되는지 확인하려고 합니다.
Fluent Bit 분기 설정
Fluent Bit은 콘솔 로그의 logtype을 읽고, rewrite_tag 필터로 로그를 나눕니다. logtype=splunk인 로그에는 altools.splunk 태그를 붙여 Splunk HEC로 보내고, 나머지는 기존 FireLens 태그를 유지해 CloudWatch로 보냅니다.
[FILTER]
    Name         rewrite_tag
    Match        *-firelens-*
    Rule         $logtype ^splunk$ altools.splunk false
    Emitter_Name altools_splunk_emitterfluent-bit.conf
마지막 false는 기존 태그의 로그를 남기지 않는 설정으로, Splunk로 분기한 로그가 CloudWatch에도 전송되는 것을 막습니다. logtype이 없는 로그도 CloudWatch로 보냅니다.
확장성을 고려한 애플리케이션과 Fluent Bit의 역할
목적지가 늘어나도 애플리케이션의 로그 생성 코드를 그대로 쓰고 싶습니다. 애플리케이션은 로그 종류와 내용을 정하고, Fluent Bit은 목적지에 맞게 변환해 보내도록 역할을 나누려고 합니다.
현재 logtype의 system은 로그 종류를, splunk는 목적지를 뜻합니다. PoC에서는 현재 설정을 사용하고, 여러 서비스에 적용할 때는 logtype을 로그 종류로 통일할지 검토하려고 합니다. 목적지가 바뀌어도 애플리케이션의 logtype은 유지하고 Fluent Bit의 분기 설정을 바꾸려는 의도입니다.
애플리케이션이 Splunk HEC 형식을 직접 만들고 있다면, 형식 변환도 Fluent Bit에 맡길지 검토하려고 합니다. 목적지를 추가할 때 필요한 코드·설정 변경을 비교하고, 어디까지 공통화할지는 내일 정리해보려고 합니다.
버퍼와 전송 실패
Splunk 통신이 끊겼을 때 로그가 얼마나 쌓이는지, 태스크가 종료될 때 로그가 유실되는지 확인하려고 합니다.
- 재시도:
Retry_Limit 5로 설정했습니다. 전송 단위인 청크가 재시도 한도를 소진하면 기본적으로 폐기될 수 있습니다. - 버퍼:
rewrite_tag의 emitter는 기본적으로 10M 한도의 메모리 버퍼를 씁니다. 한도에 도달하면 로그 처리가 멈출 수 있습니다. Splunk 전송 지연이 CloudWatch 전송에도 영향을 주는지 확인해야 합니다. - 종료: 메모리에 남은 로그는 프로세스 종료 때 유실될 수 있습니다.
Grace 30과 ECS의 종료 대기 시간을 함께 확인하고, 태스크 종료 전에 남은 로그를 전송할 수 있는지 확인하려고 합니다.
통신 실패·복구와 태스크 종료를 재현해 유실·중복 여부를 확인할 계획입니다. 기존 CloudWatch 로그 수집에 미치는 영향도 확인한 뒤, 다른 서비스에 적용할지 결정하려고 합니다.
공통 설정과 서비스별 설정
Fluent Bit 저장소를 만들어 이미지와 설정을 관리하려고 합니다. 서비스별 설정을 모아 공통으로 쓸 설정과 개별 설정으로 나눌 계획입니다.
| 항목 | 공통 설정 후보 | 서비스별 설정 후보 |
|---|---|---|
| 로그 형식 | 로그 종류·발생 시각·이벤트 ID | 이벤트 내용·추가 필드 |
| 로그 처리 | 파싱·분기·파싱 실패 처리 | 파서·필드 변환 |
| 전송 | CloudWatch·Splunk 연결 방식 | 로그 그룹·스트림·인덱스·sourcetype·비밀값 참조 |
| 실패 처리 | 버퍼·재시도·종료 기본값 | 로그량·유실 허용 범위에 따른 조정 |
| 배포 | 이미지 버전 관리·공통 확인 항목 | 적용 시점·사용 버전 |
이 목록을 바탕으로 공통 기본값, 서비스별로 바꿀 수 있는 범위, 예외 허용 기준을 정하려고 합니다. 여러 서비스에 필요한 설정은 공통으로 관리하고, 한 서비스에만 필요한 설정은 분리할 생각입니다.
한 서비스에 먼저 적용해 CloudWatch와 Splunk 로그 수집을 확인하겠습니다. 이후 서비스별 차이와 예외를 정리하며 적용 대상을 늘려가겠습니다.
장단점 비교
| 방식 | 장점 | 단점 |
|---|---|---|
| 기존 방식 1 — API 직접 전송 | • 단순한 전송 경로 • 이벤트별 전송 시점·내용 제어 | • 애플리케이션의 Splunk 의존성 • 서비스별 인증·재시도 구현 부담 • 동기 호출 시 서비스 응답 지연 가능성 |
| 기존 방식 2 — EFS·UF 파일 수집 | • 원본 로그의 영속 보관 • 장애 후 재처리 용이 • 애플리케이션과 전송 처리 분리 | • 로그 전달용 중간 저장소로 EFS 사용 • EFS·EC2·UF 운영 부담 • EFS·EC2 각각의 사용 비용 • 파일 보관·삭제 정책 관리 • 단계별 수집 지연 추적의 복잡성 |
| PoC — FireLens·Fluent Bit | • 수집·분기 설정 공통화 • 목적지 추가·변경 용이 • 애플리케이션의 전송 코드 축소 | • 태스크별 CPU·메모리 사용 • 버퍼 한도·재시도 소진·종료 시 유실 가능성 • 수집 장애가 애플리케이션에 영향을 줄 가능성 • 원본 보관·재처리 경로의 별도 설계 필요 |