상황
출석 챌린지의 사용 패턴을 반영해 스테이징 서버에서 부하테스트를 진행했습니다.
- 기본 흐름: 토큰 발급 → 출석 상태 조회(
today) - 추가 요청: 출석 확정·현황판 조회
부하를 높이자 응답 시간이 목표보다 길어졌습니다.
문제
클라이언트와 다음 조건을 서버 장애로 판단하기로 합의했습니다.
- HTTP 5xx 응답
- 응답 시간 3초 초과
모든 API의 p99 기준은 3s 이내로 정했습니다.
초기 부하테스트에서 모든 API의 p99가 3s를 초과했습니다. 요청 처리에 성공해도 응답 지연으로 클라이언트의 서버 장애 기준을 넘는 것이 문제였습니다.
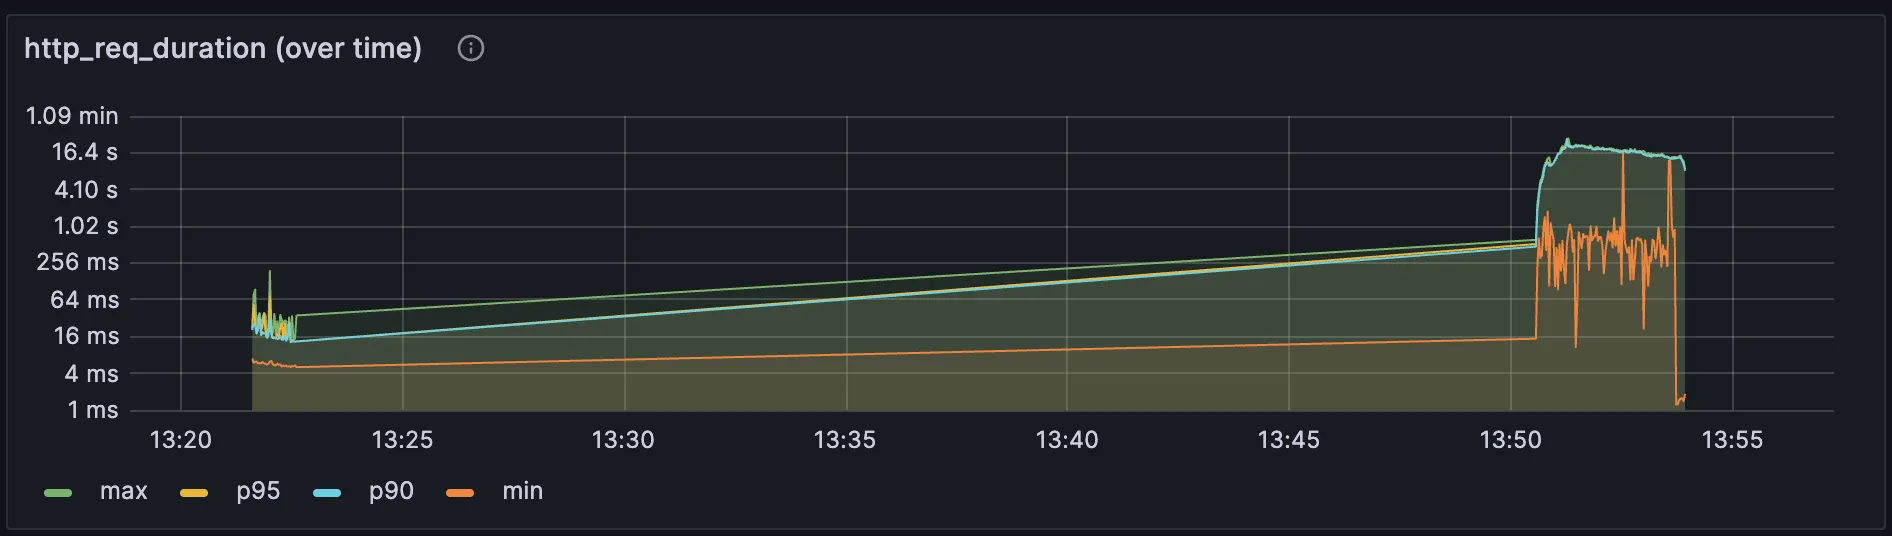
- 그래프: 전체 요청의 max·p95·p90·min
원인
요청 트레이스로 지연 구간을 찾고, 서버·Redis·DB 지표를 비교해 원인을 좁혀가기로 했습니다.
출석 상태 조회(today)
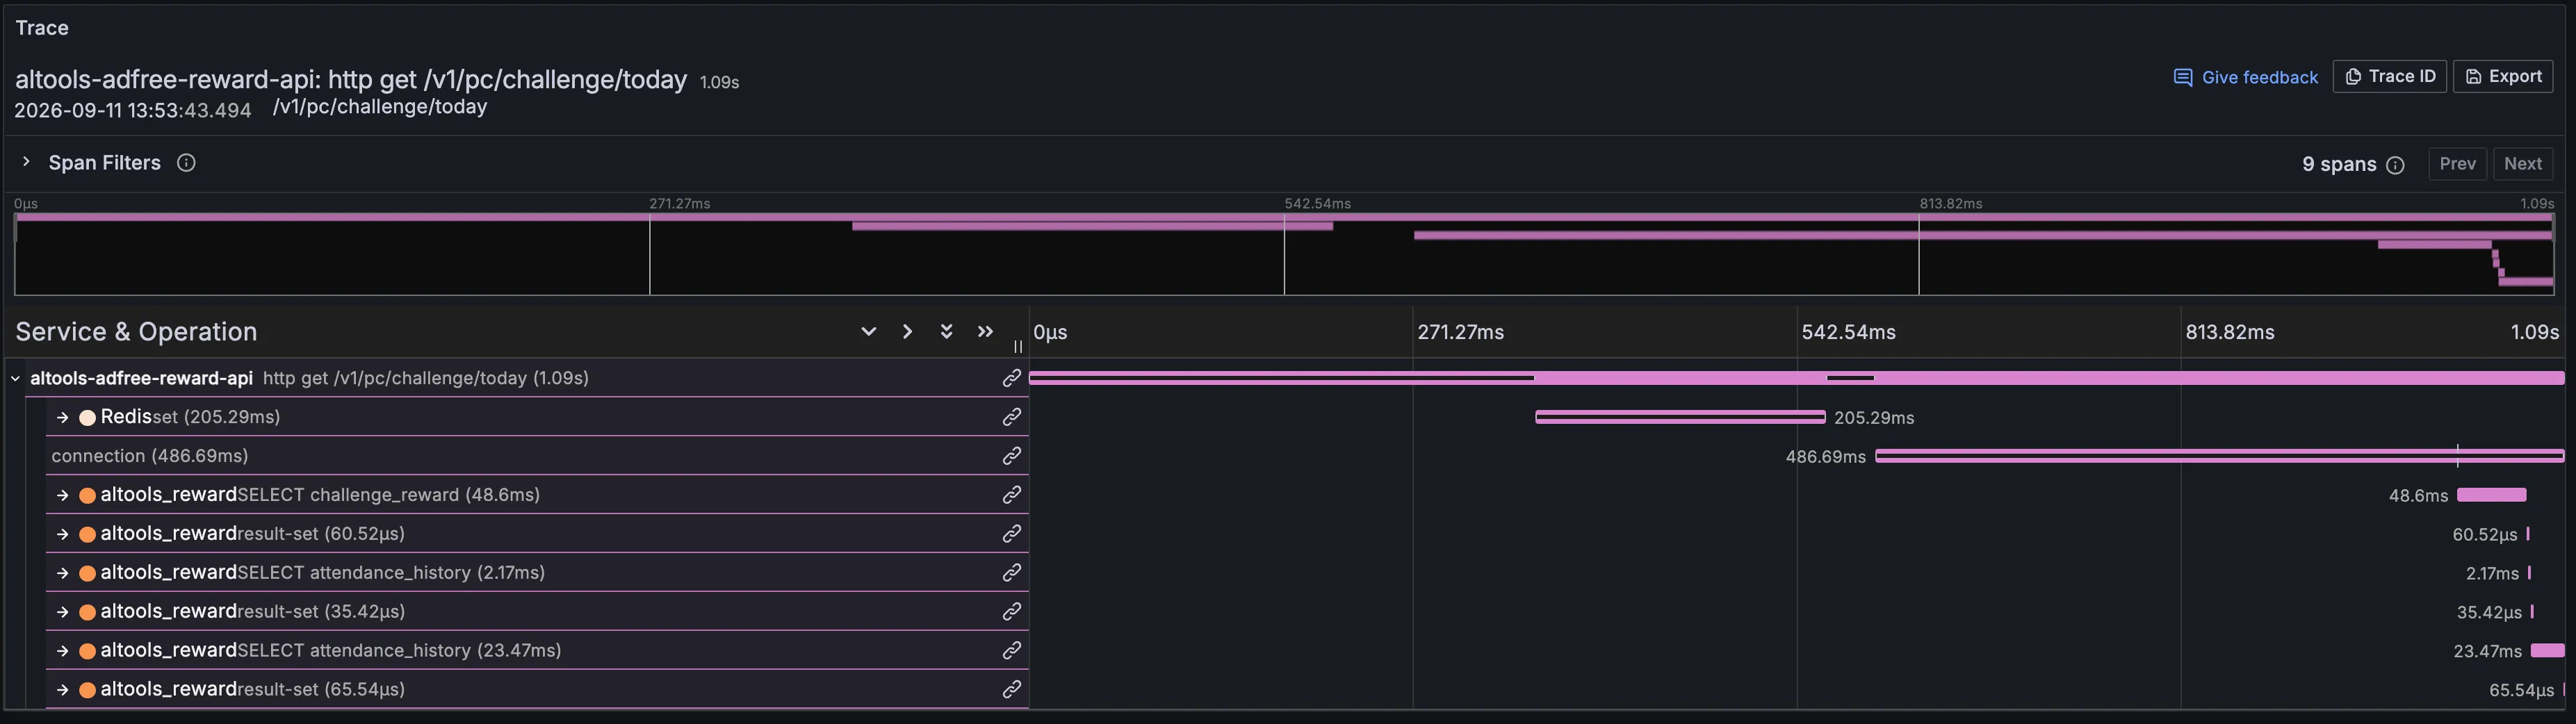
- 전체: 1.09초
- Redis
set: 205.29ms connectionspan: 486.69ms
현황판 조회(board)
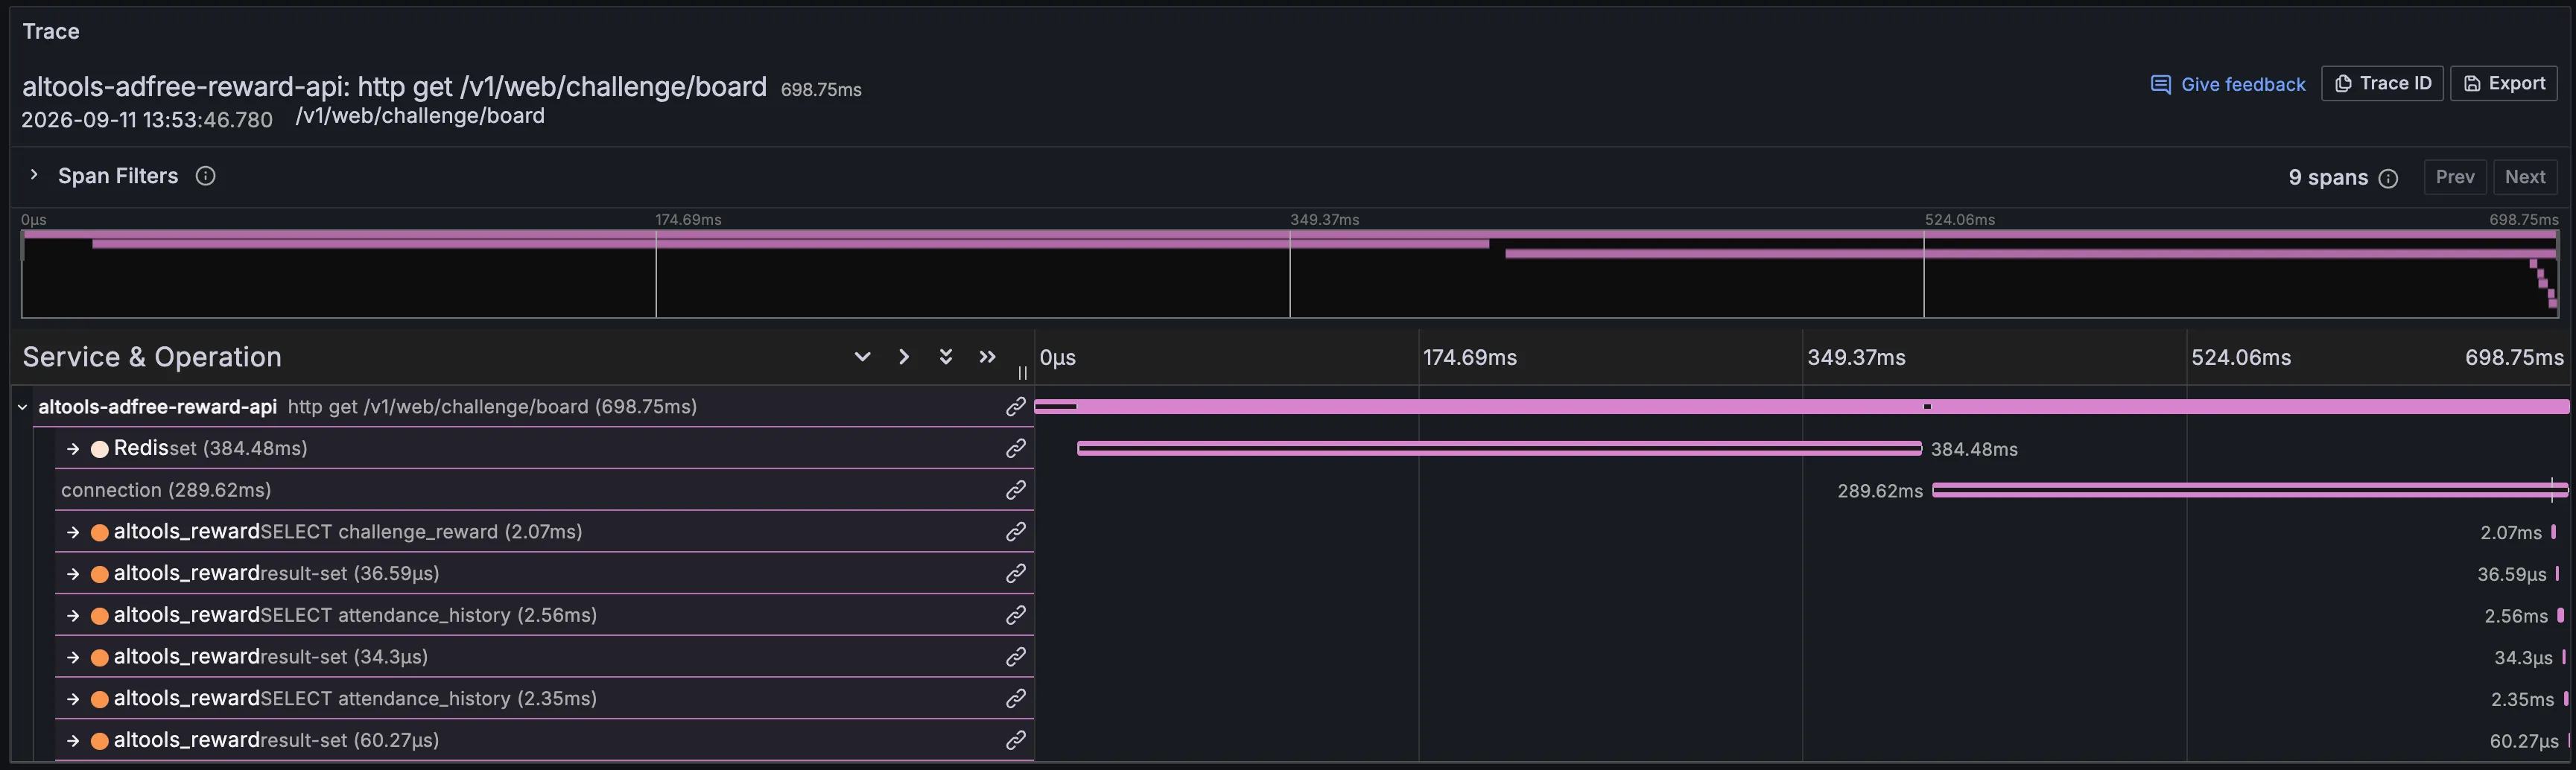
- 전체: 698.75ms
- Redis
set: 384.48ms connectionspan: 289.62ms
두 요청에서 Redis 호출과 DB 처리 지연을 확인했습니다.
서버
| 지표 | 최대 사용률 |
|---|---|
| CPU | 약 100% |
| 메모리 | 약 30.5% |
Redis
| 지표 | 최대 사용률 |
|---|---|
| 엔진 CPU | 약 0.87% |
| 메모리 | 약 3.88% |
DB
| 설정·지표 | Master | Replica |
|---|---|---|
| 최대 풀 크기 | 10개 | 10개 |
| 커넥션 획득 타임아웃 | 30초 | 30초 |
| 커넥션 획득 p99 · 표시 구간 최대 | 1.25s | 1.36s |
측정한 DB CPU 사용률입니다. 측정일과 인스턴스 사양을 확인하지 못해, 이번 풀 조정은 커넥션 획득 시간을 기준으로 진행했습니다.
| 대상 | 주요 요청 | HTTP 메서드 | 평시 CPU | 피크 CPU |
|---|---|---|---|---|
| Replica | today 약 200 RPS | GET | 약 4.0% | 약 7.8% |
| Master | 출석 확정 약 10 ~ 15 RPS | POST | 약 4.0% | 약 5.87% |
해결
부하 조건을 고정해 변경 전후를 비교했습니다.
1차 개선 · DB 풀 조정
판단 이유
DB 커넥션 획득에 대기가 발생했습니다. 풀 크기를 조정해 대기 시간을 줄이기로 했습니다.
변경 사항
DB 풀을 조정하고, 태스크 2개와 태스크당 1 vCPU·4GB는 유지했습니다.
측정 결과
커넥션 획득 대기는 줄었지만, 전후 트레이스에서 SELECT 세 건씩 비교한 실행 평균은 증가했습니다. API 지연이 남아 서버 CPU와 Redis 호출을 확인했습니다.
- CPU 사용률: 최대 약 98.9%
- 메모리 사용률: 최대 약 24.24%
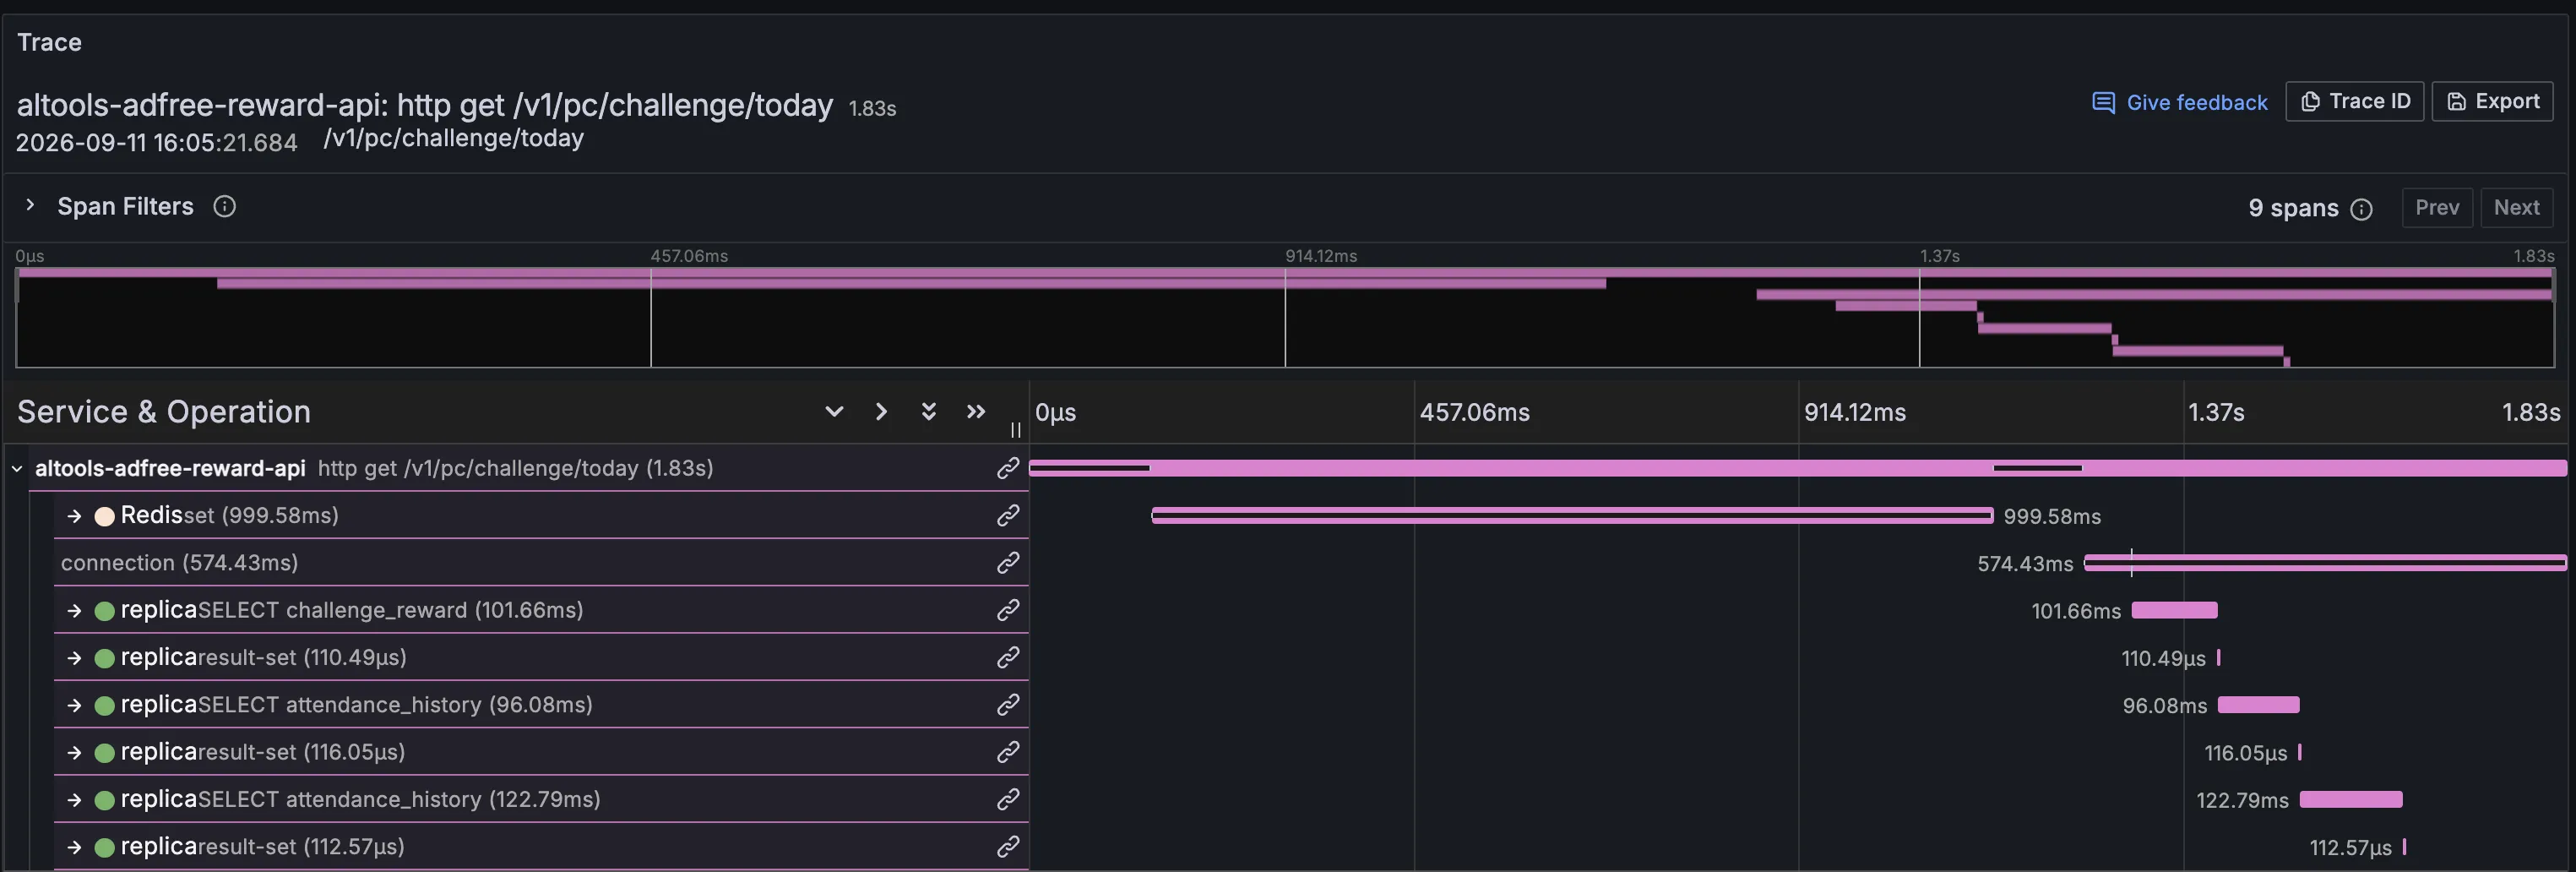
- 전체: 1.83초
- Redis
set: 999.58ms connectionspan: 574.43ms- SELECT: 101.66ms · 96.08ms · 122.79ms
2차 개선 · 태스크 증설
판단 이유
DB 풀 조정 후에도 서버 CPU가 98.9%까지 상승했습니다. 태스크를 늘려 CPU 부하를 분산하기로 했습니다.
변경 사항
- 먼저 태스크를 2 → 4개로 늘리고, 태스크당 1 vCPU·4GB를 유지했습니다.
- 이후 태스크를 4 → 8개로 늘리면서 CPU도 1 → 2 vCPU로 증설했습니다.
측정 결과
태스크 4개
- CPU 사용률: 표시 구간 최대 약 100%
- 메모리 사용률: 표시 구간 최대 약 24.24%
- API p99: 3s 초과
처리량은 늘었지만 지연이 남았습니다. 서버 CPU 경합이 Lettuce 이벤트 루프 실행을 지연시킨다는 가설을 세우고 CPU 증설을 함께 적용했습니다.
Lettuce 실행 흐름
Lettuce의 명령 처리 흐름을 요약한 의사 코드입니다.
// 호출 스레드: 비동기 명령 제출
RedisFuture<String> future = async.set(key, value);
// 동기 API라면 응답 완료 또는 타임아웃까지 대기
return awaitOrCancel(future, timeout);

// Netty 이벤트 루프: 명령 전송 → Redis 응답 수신
onResponse(buffer) {
    decode(buffer, command); // 응답 해석
    command.complete();     // Future 완료 → 호출 스레드 대기 해제
}
동기 호출은 FutureSyncInvocationHandler, 응답 처리는 CommandHandler 구현을 참고했습니다.
- 동기 대기: 호출 스레드가 결과를 기다립니다. 대기 자체가 CPU를 계속 소비하지는 않습니다.
- 이벤트 루프: 응답을 해석하고 Future를 완료합니다. 여기서 실행되는 콜백이 블로킹하면 다른 I/O도 지연됩니다.
- CPU 증설: 이벤트 루프가 CPU를 배정받기까지의 대기를 줄일 수 있다고 판단했습니다. 실제 경합 여부는 CPU 프로파일로 확인해야 합니다.
태스크 8개 · 태스크당 2 vCPU·4GB
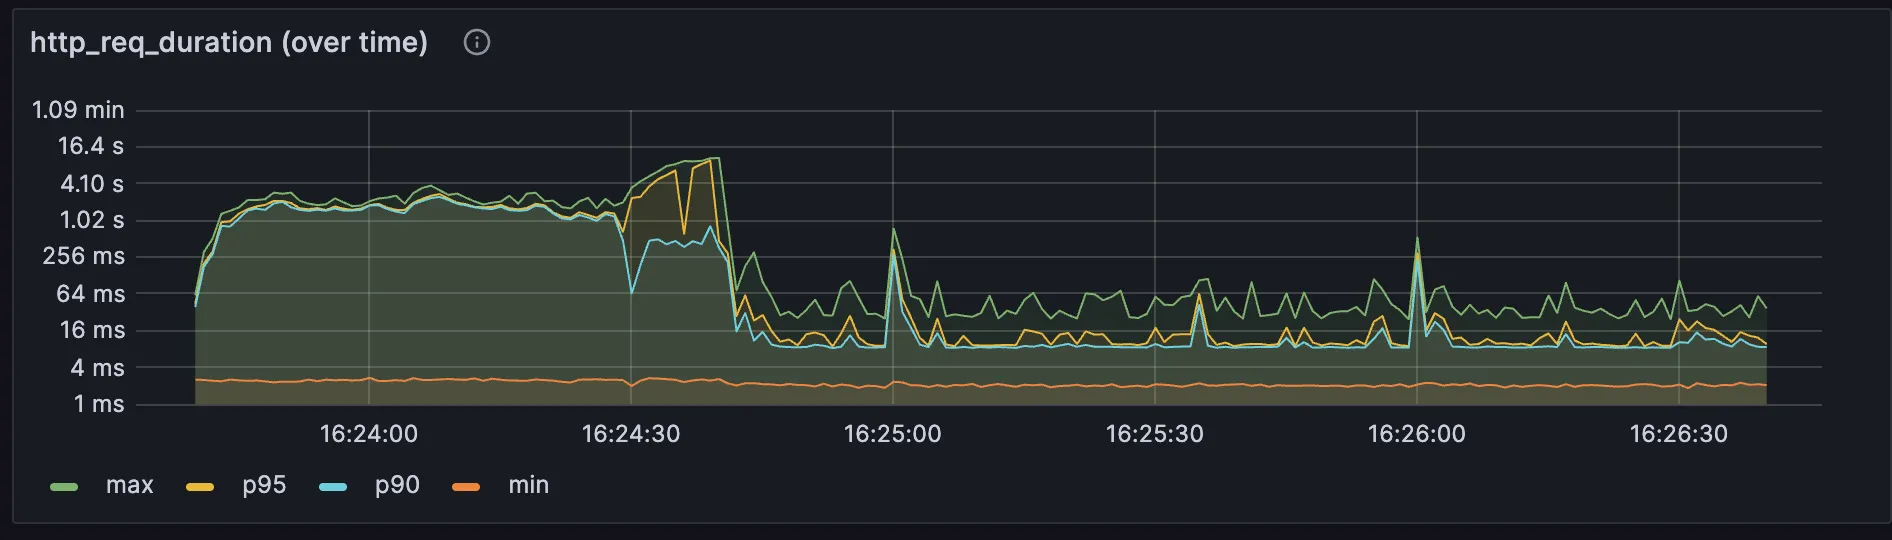
- API p99: 모두 3s 이내
- 최대 응답 시간: 10.74초
3차 개선 · 태스크당 CPU 증설
판단 이유
2 vCPU 구성에서 p99가 3s 이내로 줄었습니다. CPU 설정을 유지한 채 태스크 수를 줄여도 목표를 충족하는지 확인했습니다.
변경 사항
태스크당 2 vCPU·4GB를 유지하고, 태스크를 8 → 5개로 줄였습니다.
측정 결과
최종 구성: 태스크 5개 · 태스크당 2 vCPU·4GB
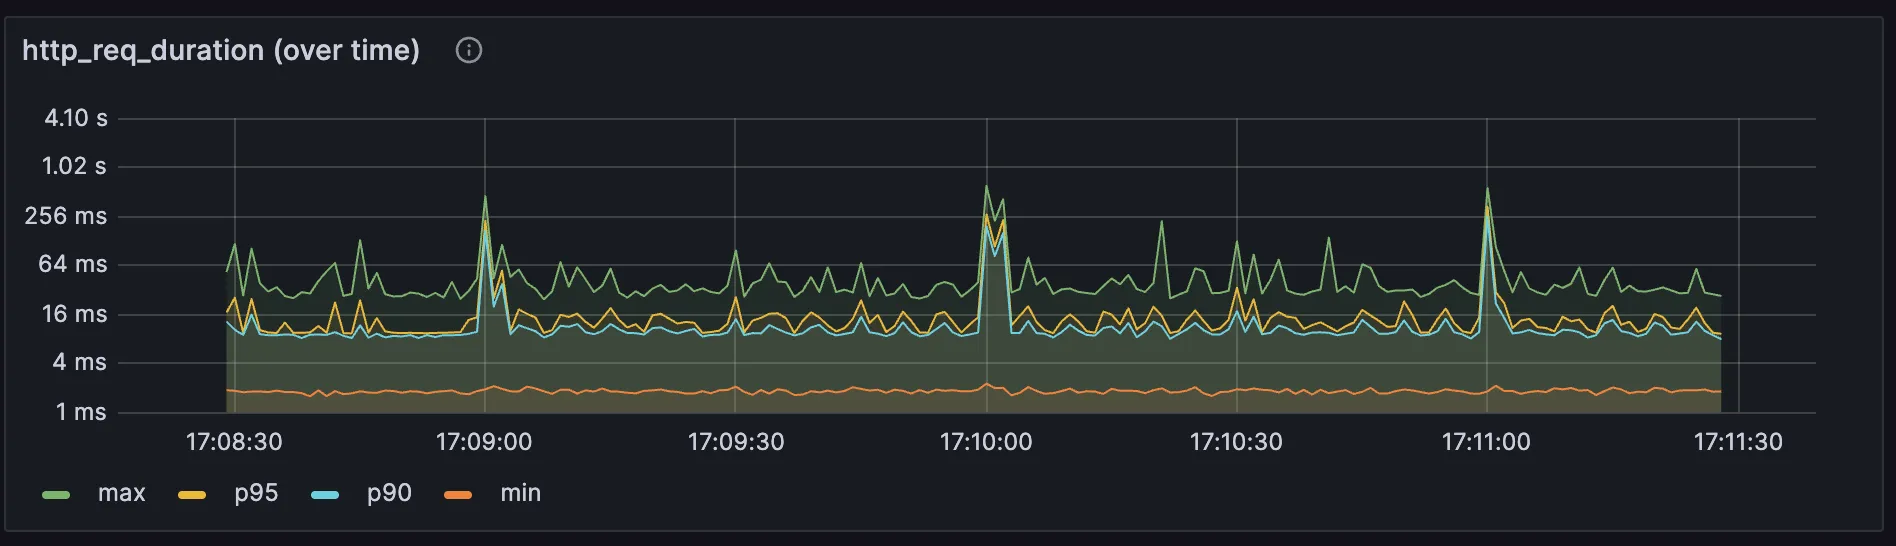
전체 요청의 max·p95·p90·min이며, 앞선 그래프와 축 범위가 다릅니다.
- 최대 응답 시간: 603.41ms
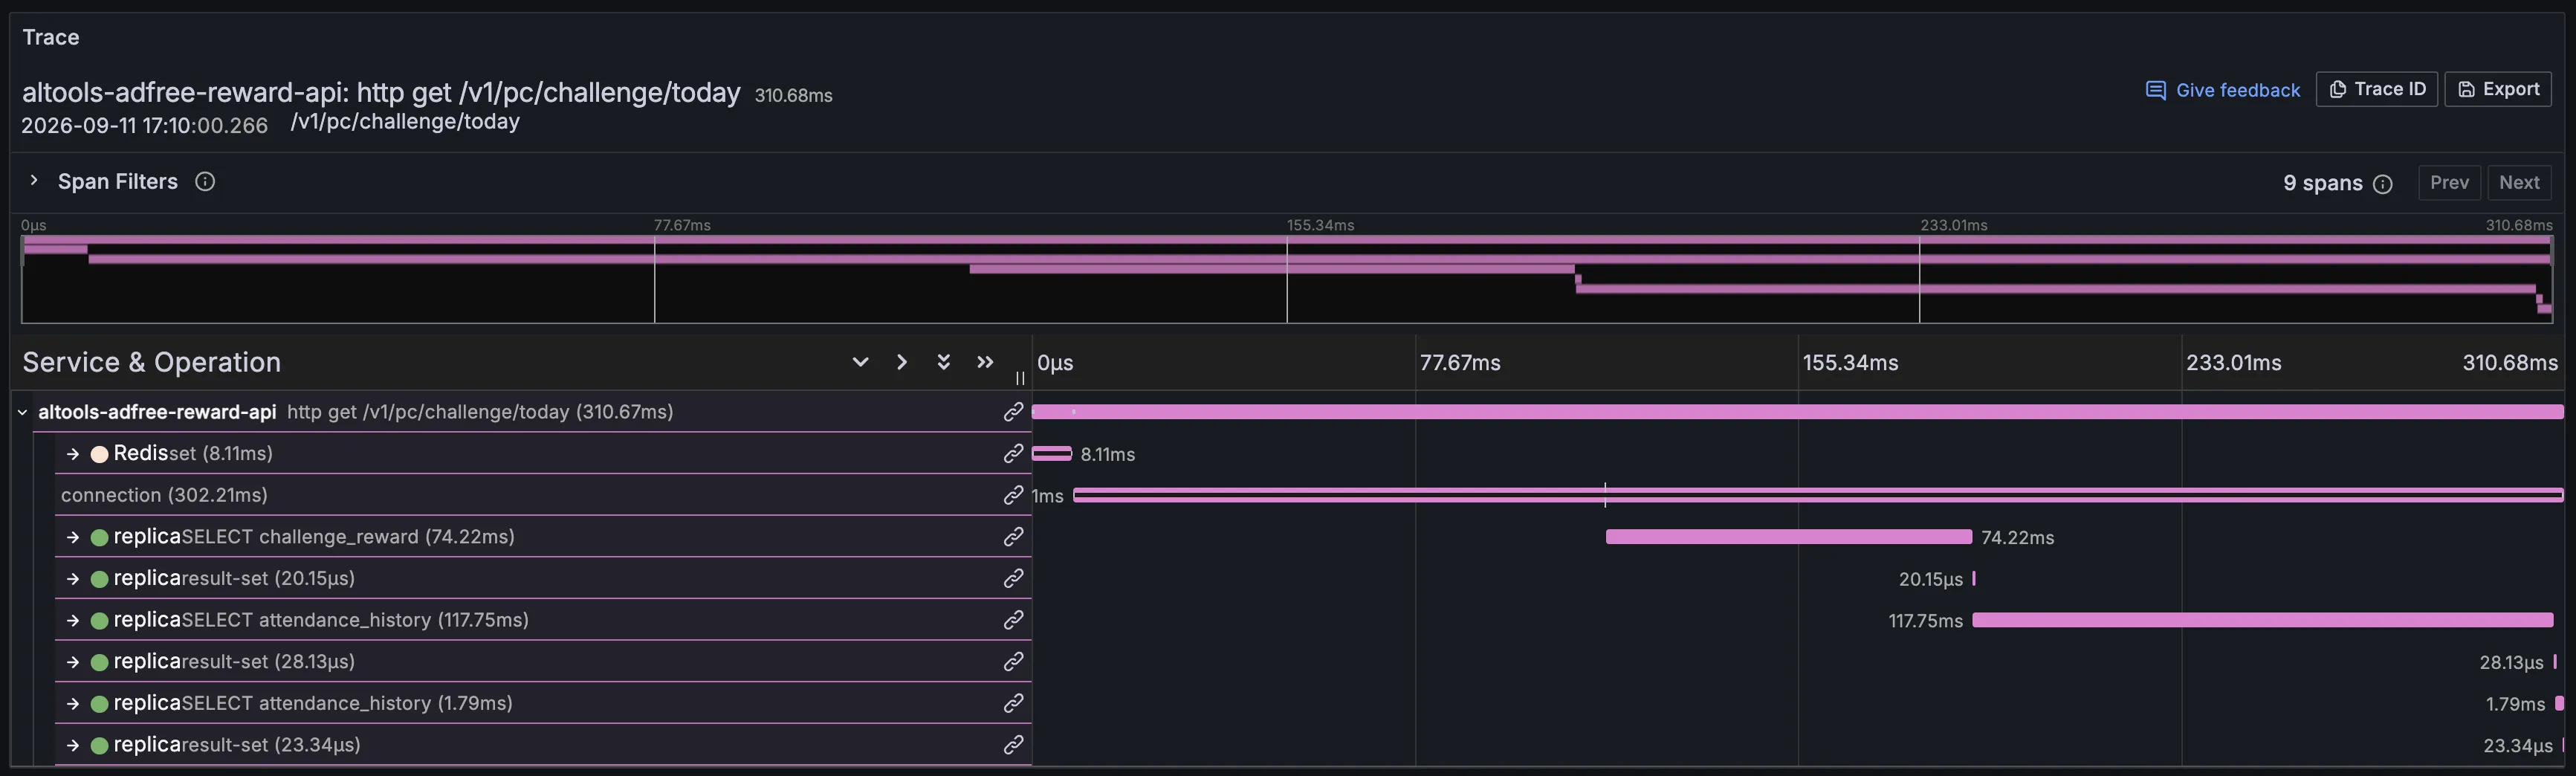
- 전체: 310.68ms
- Redis
set: 8.11ms connectionspan: 302.21ms
비교한 트레이스에서 Redis 호출 시간도 줄었습니다. CPU·태스크 수·배포 상태가 함께 달라져 CPU 경합이 원인인지는 추가 확인이 필요합니다.
트러블슈팅 · Too many connections
롤링 배포 중 커넥션 여유 확보
태스크 수를 늘렸다 줄이는 과정에서 커넥션이 부족해 Too many connections가 발생했습니다. 기존 태스크를 강제로 종료하고 커넥션 여유를 확보한 뒤 교체하기도 했습니다.
현재 롤링 배포는 신규 태스크를 먼저 늘린 뒤 기존 태스크를 종료합니다. 신규·기존 태스크가 공존하는 동안 DB 커넥션도 증가해 교체가 막힐 수 있습니다.
풀 크기를 정할 때 배포 중 최대 태스크 수까지 계산해야 한다는 점을 배웠습니다. DB별로 최대 태스크 수에 풀 상한을 곱하고, 다른 클라이언트와 잔존 커넥션을 위한 여유도 확보해야 합니다.
비정상 종료 후 커넥션 회수
정상 종료 시 HikariDataSource.close()가 호출되면 풀이 커넥션을 정리합니다. 그렇다면 정상 종료하지 못했을 때는 어떻게 될지 생각해 봤습니다.
비정상 종료·네트워크 단절로 DB가 연결 종료를 감지하지 못하면 커넥션이 남을 수 있습니다. 잔존 커넥션으로 max_connections에 도달하면 새 태스크도 커넥션을 확보하지 못합니다.
정상 종료 시 커넥션 정리와 비정상 종료 후 회수를 함께 고려해야 한다는 점을 배웠습니다. 종료 유예 시간과 유휴 커넥션 만료 설정을 점검하고, 장애 시 회수 시간을 확인해야 합니다.
결과
DB 풀 조정과 태스크·CPU 증설을 거쳐, 검증한 부하에서 모든 API의 p99가 3s 이내라는 목표에 도달했습니다.
| API | HTTP 메서드 | 초기 p99 | 최종 p99 |
|---|---|---|---|
| 토큰 발급 | POST | 20.78s | 20.43ms |
출석 상태 조회(today) | GET | 21.00s | 80.8ms |
| 출석 확정 | POST | 21.28s | 55.9ms |
현황판 조회(board) | GET | 20.86s | 33.53ms |
튜닝하며 든 생각
튜닝하면서 CPU 상한과 DB 커넥션 상한을 함께 고려해 설정을 고민했습니다.
- 서버 CPU 부족: 태스크당 풀을 줄여 DB 커넥션 여유를 확보하고 스케일 아웃합니다.
- 서버 CPU 여유·커넥션 획득 대기 발생: DB 처리 여유를 확인하고 풀을 늘려 스케일 아웃을 최소화합니다.
여기에 부하를 높일 때 먼저 상한에 도달하는 자원부터 조정하면 되겠다는 생각이 들었습니다. 한쪽을 조정하면 다른 자원이 병목이 될 수 있으므로, 같은 부하에서 다시 측정하며 설정을 맞추려 합니다.