3줄 요약
- 이월된 jemalloc 조사를 로컬 Docker 실측으로 대체해 RSS 증가의 원인을 확정했다.
- 인사이트: 앱은 메모리를 거의 전부 반납한다. free된 메모리를 OS에 돌려주지 않는 glibc가 원인이다.
- 다음 주는 test 환경에 두 처방(
MALLOC_ARENA_MAX=2, jemalloc)을 나눠 배포해 운영급 트래픽으로 비교한다.
지난주 Try 점검
- (이월) 테스트 환경에 jemalloc 프로파일링(
LD_PRELOAD)을 배포해 살아있는 1GB의 할당 스택 확인하기 → 결과: 배포 대신 로컬 Docker에서 동일 이미지로 실측했다. 프로파일링으로 누수 없음을 확인했고, glibc vs jemalloc A/B 비교까지 끝냈다. 이번 주 본문. - 『주니어 백엔드 개발자가 반드시 알아야 할 실무지식』 3장 읽고 정리하기 → 결과: 읽고 스터디 노트에 정리했다. 기억할 것만 아래 “이번 주의 공부”에 남긴다.
이번 주의 문제: NMT 밖 1GB는 정말 살아있는 메모리인가
이전 과정 요약
6월에 운영 인스턴스 한 대가 컨테이너 메모리 limit에 닿아 OOMKill로 재시작되는 장애가 있었다. 직접 원인이던 다이렉트 버퍼 캐시 축적은 JVM 옵션(jdk.nio.maxCachedBufferSize=262144)으로 막았지만, 재시작 주기가 1일에서 5일로 늘었을 뿐 여전히 죽었다. 3주차에 그 나머지를 추적했다 — 힙은 2GB인데 RSS는 3.7GB, JVM이 스스로 아는 메모리(NMT committed 2.5GB)와의 격차가 1.2GB였다. trim으로 걷히는 잔류는 0.2GB뿐이어서 나머지 1GB는 “trim 되지 않는 메모리”라는 결론에 다다랐다.
상황
이번 실험은 이 1GB의 출처를 확인하는 것이 목표였다. 배포 없이도 로컬에서 확인할 수 있겠다 싶어, 로컬 Docker에 실험 환경을 만들어 부하 테스트를 진행했다.
- 이미지: 운영과 같은 이미지 — glibc·jemalloc 내장
- 메모리 limit: 2GiB
- JVM 플래그: 운영과 같음 —
MaxRAMPercentage=50+ NMT +jdk.nio.maxCachedBufferSize=262144
시도
-
프로파일링 — 누수 없음 확인. 프로파일링을 통해 부하를 걸어둔 채 60초간 네이티브 malloc/free를 기록하고 주소를 매칭해 미해제분을 계산했다.
- glibc: 샘플된 malloc 873건/5.2MB 중 미해제 0.02MB
- jemalloc: 샘플된 malloc 2,123건/12.4MB 중 미해제 0.06MB — 프로파일러 자체 버퍼 제외
할당 주체도 앱이 아니라 JIT 컴파일러(C2)였다. 상위 스택이
PhaseIdealLoop::Dominators,Matcher::Label_Root같은 컴파일 작업 메모리였고 작업 후 전량 free됐다.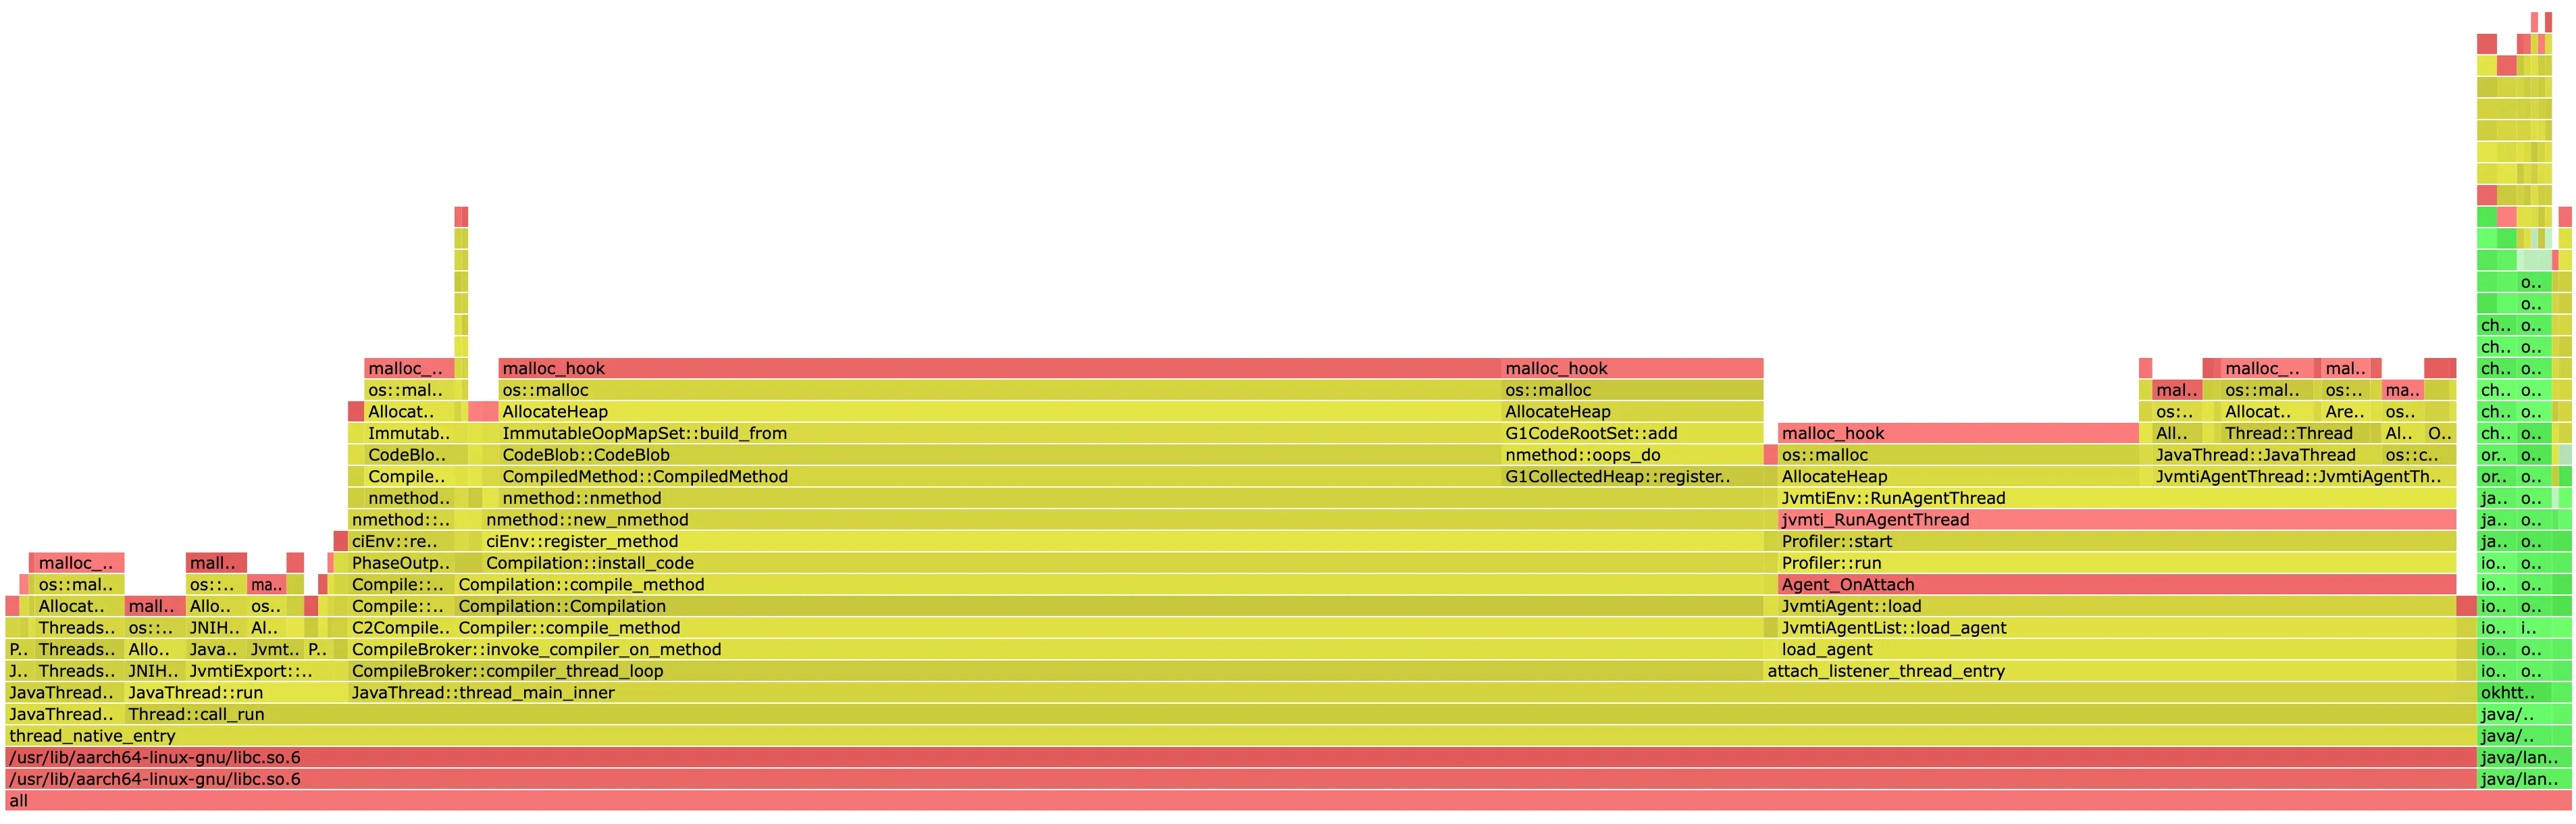
NIO 다이렉트 버퍼의 live는 단 1건 6.8KB — 3주차에 배포한
maxCachedBufferSize방어가 작동 중이라는 실측 확인이다. 후보 넷 중 앱 쪽 누수(zlib 등)는 여기서 제외됐다. -
격차의 출처 — 주소 단위 대조. OS가 보는 메모리(
/proc/1/smaps)와 JVM이 아는 메모리(NMT detail, 영역별 주소 범위)를 부하 테스트 전후로 캡처해 주소 단위로 대조했다. RSS 증가 +1,074MB의 내역은 이렇다.- Java 힙: +815MB — Xmx 이내 정상 동작
- GC·Metaspace·Code: +33MB
- NMT가 추적하지 못하는 익명 영역: +225MB — 159MB→384MB
mmap 내역을 확인하니, 증가분의 99%(223MB)는 64MB 경계에 정렬된 익명 매핑 78개에 나뉜 단편화된 메모리였다 — glibc가 스레드 arena를 만들 때 나타나는 배치다.
free된 메모리는 OS가 아니라 glibc 내부의 빈 공간 리스트(bin)로 돌아가 재사용을 기다린다. 그래서 프로파일러에는 정상 해제로 보여도 RSS는 줄지 않는다. 미해제는 0.02MB뿐인데 격차는 수백 MB까지 벌어진 것도 이 때문이다.
- 사후 회수 시도 — 효과 미미.
jcmd System.trim_native_heap으로 glibc가 쥔 메모리 반환을 시도했다. 회수는 5MB에 그쳤다. 쌓인 메모리를 나중에 걷어내는 방식으로는 격차를 줄일 수 없었다. - 업계 선례 확인. 같은 문제가 OpenJDK 공식 버그 JDK-8193521로 등록돼 있고, 대응 선례도 두 갈래로 쌓여 있다.
- ⭐ Arcesium: NMT 6.77GiB vs RSS 8.72GiB를 같은 방법으로 진단, jemalloc 전환으로 단편화 400GB→125GB(-68%)
- ⭐ Hadoop: 2011년부터
hadoop-env.sh에MALLOC_ARENA_MAX=4기본 — Cassandra도 같은 조치 - Cloud Foundry Java 빌드팩: 모든 Java 앱에
MALLOC_ARENA_MAX=2기본 주입 — Heroku 튜닝 가이드와 컨테이너 memory limit 환경의 OOMKill 사례도 같은 문제를 다룬다 - BetterUp·Finbox: jemalloc 전환, 코드 수정 없이 해결
- Redis: jemalloc이 기본 할당자
- glibc vs jemalloc A/B 실측. 앱·이미지·부하·limit을 전부 고정하고
LD_PRELOAD만 바꿨다. 지표는 격차(= VmRSS − NMT committed)이다.
- 무엇인가 — Jason Evans가 FreeBSD용으로 만든 범용 malloc 구현체다(jemalloc.net). 멀티스레드 환경의 락 경합과 단편화를 줄이는 게 설계 목표로, Redis의 기본 할당자이고 Meta가 자사 서비스 전반에 쓴다.
- free까지 통째로 바뀐다 —
LD_PRELOAD로 끼우면malloc뿐 아니라free·calloc·realloc까지 전체 패밀리가 교체된다. 할당과 해제는 같은 할당기의 쌍이어야 하기 때문이다. glibc의free는 jemalloc이 할당한 메모리의 내부 구조를 모른다. 앱 코드는 한 줄도 안 바뀐다.
같은 20분 동안 glibc의 격차는 48→486MB로 10배가 됐고, jemalloc은 사실상 제자리였다. 최종 RSS도 glibc 1,835MB, jemalloc 1,591MB로 244MB 차이가 났다. glibc의 peak RSS 1,881MB(limit의 92%)는 운영 OOMKill 사이클의 재현이다 — 힙이 정상적으로 커지는 위에 arena가 쥔 메모리가 쌓여 limit에 닿는다. jemalloc은 background_thread:true가 필수다 — 없으면 부하가 멈춰도 반환이 일어나지 않는 것을 1차 실험에서 확인했다.
- glibc를 유지하는 대안 —
MALLOC_ARENA_MAX실측. Hadoop과 Cloud Foundry가 기본으로 심을 만큼 검증된 처방이라, 나도 같은 부하를 새 컨테이너에 걸어 arena 축소 단독과 trim 조합을 나란히 재봤다.
arena 축소 단독으로 효과의 대부분이 나온다 — 275→69MB(-75%). 부하 후 64MB 정렬 arena 매핑이 기본값 78개에서 6개로 줄었으니, 격차가 쌓이는 arena 수 자체가 줄어든 것이다. trim_threshold를 얹으면 69→31MB로 조금 더 줄어들 뿐이다. 3주차 재현기에서는 같은 플래그가 RSS를 44% 늘렸는데 이번엔 정반대다. 튜닝 플래그는 워크로드마다 실측해야 한다는 걸 다시 확인했다.
짚고 갈 것이 하나 있다. 이 스케일에서는 튜닝된 glibc가 jemalloc보다 격차 절대값이 오히려 작다. 두 개선책의 장단은 이렇게 갈린다.
- glibc 튜닝(
MALLOC_ARENA_MAX=2)- 장점: 격차 절대값이 가장 작고(31–69MB), 환경변수 한 줄로 끝난다
- 단점: arena 2개를 톰캣 워커 스레드 전체가 나눠 쓰므로 동시성이 높으면 할당 지연이 생길 수 있다
- jemalloc
- 장점: 무한 누적이 없고 부하가 멈추면 반환하며, 락 경합 걱정이 없다
- 단점: 성능을 위해 스레드 캐시(tcache) 등을 의도적으로 들고 있어 격차의 하한치가 높다(약 245MB)
해결
RSS 증가의 원인은 free된 메모리를 OS에 반환하지 않고 arena에 쥐고 있는 glibc의 고질적인 문제다. 메모리 주소를 직접 대조했을 때, 64MB 단위로 78개로 쪼개진 매핑 값(225MB)을 직접 확인했다.
따라서 arena 개수를 줄여 단편화로 인한 RSS 증가 상한선을 둘지, jemalloc으로 전환해 단편화를 최소화할지 결정해야 했다.
MALLOC_ARENA_MAX=2 | jemalloc 전환 | |
|---|---|---|
| 격차 개선 | O — 75% 절감 (31–69MB) | O — 수렴 (약 245MB) |
| 적용 방법 | 환경변수 한 줄 | 이미지 변경 + LD_PRELOAD |
| 락 경합 | 발생 가능 | 없음 |
| 기본 보유 메모리 | 작음 | 큼 |
각 시도한 과정을 정리하면 다음과 같다.
최종 선택은 test 환경에서 두 안을 나란히 걸어 운영급 트래픽으로 가른다.
배운 것
glibc와 jemalloc의 격차 그래프가 갈린 건 배치 규칙의 차이다.
-
glibc가 파편화되는 이유
-
외부 단편화(external fragmentation) — free된 메모리가 OS로 돌아가지 못하고 RSS에 남는 상태
-
외부 단편화가 발생하는 이유 — 크기가 다른 할당을 한 영역에 섞어 둬서, free된 자리 옆에 다른 크기의 live 할당이 박히면 페이지 안에 live와 free가 섞인다
-
Top Chunk Pinning — 힙 꼭대기부터 연속으로 빈 공간만 OS에 반환할 수 있어서, 꼭대기에 live 할당이 남아 있으면 그 아래 빈 공간이 통째로 잡힌다
-
문제가 커진 이유: arena 증식 — 스레드마다 arena가 최대 코어 수 × 8개까지 늘어나, 같은 pinning이 arena 수만큼 반복된다
-
-
jemalloc이 괜찮은 이유
-
jemalloc 동작 — 할당을 크기 등급(size class)별 slab으로 나눠 한 페이지에 같은 크기 객체만 모은다. 해제가 쌓이면 페이지가 통째로 비고, 빈 페이지를
madvise로 즉시 OS에 돌려준다
-
-
jemalloc이 대신 가져오는 문제
- 격차 하한치 — 성능을 위해 스레드 캐시(tcache)와 dirty 페이지를 쥐고 있어, 부하가 없어도 기본 보유량이 크다(이번 실측 약 245MB)
- 내부 단편화(internal fragmentation) — 할당 크기를 등급으로 올림 처리하므로 등급 사이 자투리가 낭비된다
- 설정 의존 — 부하가 멈춘 뒤의 반환은
background_thread:true를 켜야 일어난다(1차 실험에서 확인) - 도입 비용 — 이미지에 라이브러리를 넣고
LD_PRELOAD를 거는 배포 변경이 필요하다
이 차이는 작년 5월에 Redis의 기본 할당자를 정리해둔 노트의 벤치마크에서 경우별로 그대로 드러난다. Redis는 redis-server -v 출력에 malloc=jemalloc-5.2.1이 찍힐 만큼 jemalloc을 내장하는데, 그 배경인 Matt Stancliff의 quicklist 벤치마크를 보면 이렇다.
- 정수 100만 개 리스트 200개(작은 객체 대량 할당): jemalloc 파편화 2%(프로세스 12.1GB), libc(ptmalloc) 33%(17.7GB) — 크기 등급 분리가 유리한 경우
- 2.5KB 원소를 동시 접근 없이 순차 저장: libc 파편화 1%로 오히려 우세, jemalloc 3% — 크기 섞임 자체가 안 생기는 경우
- 일반 조건: libc는 통상 25–40% 파편화된다고 저자가 적었다
할당자는 워크로드를 재보고 정한다는 이번 교훈이 그 노트에도 있었다. jemalloc이 다중 arena로 락 경합을 줄이도록 설계됐다는 내용은 Jason Evans의 2006년 논문 원문에 있다.
이번 주의 공부: 『주니어 백엔드 개발자가 반드시 알아야 할 실무지식』 3장
3장은 성능을 좌우하는 DB 설계와 쿼리를 다룬다. 저자가 반복해서 강조하는 건 하나다. DB 자체가 문제인 경우보다 잘못 사용해서 생기는 문제가 더 많다는 것. 기억할 내용은 세 가지다.
- 인덱스는 조회 패턴 기준으로 설계한다 — 데이터가 많을 때 풀스캔이 동시에 몰리면 DB CPU가 100%에 닿는다
- 인덱스 말고도 조회를 빠르게 하는 방법이 있다 — 사전 집계, 페이지 번호 대신 마지막 ID 기준 조회, 조회 범위 시간 제한, 전체 개수 세지 않기, 오래된 데이터 분리 보관
- 트랜잭션 경계를 정확하게 설정해야 데이터 일관성이 유지되고, 일부 기능은 트랜잭션 밖에서 실행해야 한다
실무에 적용할 점
복합 인덱스를 걸 때의 판단 기준을 정리해뒀다.
- 왼쪽 접두사 규칙 — 복합 인덱스는 선두 컬럼부터 순서대로만 탄다.
(a, b, c)인덱스는a,a+b,a+b+c조건에는 쓰이지만b나c만으로는 못 쓴다. 그래서 컬럼 순서가 인덱스 설계의 전부다. - 컬럼 순서 기준 — equality(=) 조건 컬럼을 앞에, range(부등호·BETWEEN) 조건 컬럼을 뒤에 둔다. equality끼리는 선택도(카디널리티) 높은 컬럼을 앞에 두는 게 기본이되, 자주 쓰는 쿼리 패턴이 우선이다.
- 중복 인덱스 정리 —
(a, b)인덱스가 있으면(a)단독 인덱스는 왼쪽 접두사로 커버되므로 불필요하다. 인덱스 추가 전에 기존 인덱스의 접두사로 해결되는지 먼저 본다. - 커버링까지 고려 — 자주 실행되는 쿼리라면 SELECT 컬럼까지 인덱스에 포함해 테이블 접근 자체를 없앨지 검토한다. 대신 인덱스가 커지고 CUD 비용이 늘어나니, 쿼리 실행 빈도와 실행 시간으로 판단한다.
- ESR과 filesort — MongoDB는 equality → sort → range 순서를 권하는데, MySQL도 같은 원리가 통한다. equality 다음에 sort 컬럼을 두면 인덱스 순서가 곧 정렬 순서라 filesort가 안 난다. filesort는 인덱스만으로 정렬된 결과를 얻지 못할 때 DB가 정렬 버퍼에 올려 따로 정렬하는 작업으로, 버퍼(
sort_buffer_size)를 넘으면 디스크 임시 파일까지 쓰며 느려진다. 발생 여부는EXPLAIN의Using filesort로 확인한다.
더 알아볼 것 / 질문
읽으면서 생긴 질문들이다. 답도 직접 찾아봤다.
-
파티셔닝과 샤딩, 언제 뭘 쓰나 — 읽기 부하와 쓰기 부하 중 어느 쪽이 문제인지에 맞게 선택한다. CAP에 따라 각각 세팅하는 기준이 달라지는데, 그 기준은 따로 정리할 주제로 남겼다.
-
오래된 데이터 분리 보관, 실제로 한다면
-
상황: 과거 데이터가 쌓여 조회가 느려지거나 디스크가 부족할 때. DELETE만으로는 디스크가 반환되지 않고 단편화만 심해진다
-
진행 방법
-
RANGE 파티셔닝이 돼 있으면 파티션 DROP이 가장 싸다 — 디스크가 즉시 반환되고 단편화도 없다
-
아니면 아카이브 테이블로
INSERT ... SELECT하거나 객체 저장소에 압축해 보관하고, 배치 이관 → 건수 검증 → 삭제 순서로 반복한다 -
SQL로 바로 조회할 상태를 유지하고 싶으면 MySQL 압축 테이블로 DB 안에 보관한다 — 읽기 위주 아카이브에 맞고, 텍스트 위주 데이터면 절반 이하로 줄어드는 경우가 많다
-- 행 압축: KEY_BLOCK_SIZE(8·4·2·1KB)로 압축 정도 지정
CREATE TABLE order_archive (
    id BIGINT PRIMARY KEY,
    payload JSON,
    created_at DATETIME
) ENGINE=InnoDB ROW_FORMAT=COMPRESSED KEY_BLOCK_SIZE=4;

-- 페이지 압축: 펀치 홀을 지원하는 파일시스템(ext4, XFS 등) 필요
ALTER TABLE order_archive COMPRESSION='zlib';
OPTIMIZE TABLE order_archive; -- 재작성해야 기존 데이터에 압축이 적용된다
-
-
주의점
-
이관과 삭제를 한 트랜잭션으로 묶지 않는다
- 이유: 이관 확인이 끝난 범위만 지워야 데이터 유실이 없다
- 문제: 대량 이관과 삭제가 한 트랜잭션이면 undo 로그가 비대해지고, 실패하면 롤백이 그만큼 오래 걸린다
-
LIMIT이나 PK 범위로 나눠 지운다
- 이유: 삭제량이 곧 undo 로그와 binlog 기록량이다
- 문제: 한 번에 지우면 row 기반 binlog에 삭제된 행이 전부 기록돼 복제 지연이 생기고, 긴 삭제 트랜잭션은 undo purge를 밀리게 해 다른 쿼리까지 느려진다
-
삭제 조건이 인덱스를 타는지 확인한다
- 이유: 조건이 인덱스를 못 타면 삭제가 풀스캔으로 돈다
- 문제: 잠금 범위가 gap lock까지 넓어져 운영 쿼리가 대기한다
-
ON DELETE CASCADE와 트리거를 확인한다- 이유: 삭제가 그 테이블에서 끝난다는 보장이 없다
- 문제: 의도하지 않은 테이블까지 연쇄 삭제된다
-
KEY_BLOCK_SIZE는 실제 데이터 샘플로 압축률을 재보고 정한다- 이유: 값이 작을수록 압축률은 높아지지만 압축/해제 CPU 비용이 커진다
- 문제: 너무 작게 잡으면 압축 실패 → 페이지 분할 → 재압축이 반복돼 오히려 느려진다
-
페이지 압축을 쓰면 용량 모니터링은
du기준으로 본다- 이유: 펀치 홀 방식이라 파일 크기(
ls)는 그대로고 실제 디스크 점유(du)만 줄어든다 - 문제:
ls기준으로 보면 압축 효과가 안 보이고, sparse 파일을 지원하지 않는 백업 도구는 백업본에서 압축 효과가 사라진다
- 이유: 펀치 홀 방식이라 파일 크기(
-
공간 회수용
OPTIMIZE TABLE은 트래픽 적은 시간대에 별도로 계획한다- 이유: 온라인 DDL이라도 사실상 테이블 전체를 복사한다 — 테이블 크기만큼 디스크 여유가 필요하고 복제 지연이 생긴다
- 문제: 시작과 끝에 메타데이터 잠금(MDL)을 잡아서, 오래 실행 중인 쿼리가 있으면 그 뒤로 들어오는 쿼리까지 전부 대기한다. 중단이 부담되면 gh-ost나 pt-online-schema-change로 복사 속도를 조절한다
- 참고: InnoDB에선 “Table does not support optimize, doing recreate + analyze instead” 메시지가 나온다 — 에러가 아니라 재생성으로 대신 처리했다는 정상 동작이다
-
OPTIMIZE TABLE은 정기 실행하지 않고 일회성으로 돌린다- 이유: InnoDB는 주기적인 OPTIMIZE가 필요 없는 경우가 대부분이다. 대량 삭제·아카이빙 직후
information_schema.TABLES의DATA_FREE로 단편화를 확인하고 돌리는 게 정석이다 - 문제: 정기 실행은 매번 테이블 전체 복사 비용을 내는 낭비가 되기 쉽다
- 이유: InnoDB는 주기적인 OPTIMIZE가 필요 없는 경우가 대부분이다. 대량 삭제·아카이빙 직후
-
주기 실행이 꼭 필요하면 MySQL 이벤트 스케줄러보다 외부 배치(cron)를 쓴다
-- 이벤트 스케줄러로 매월 1회 실행 (기본 ON, RDS는 파라미터 그룹에서 설정) CREATE EVENT optimize_order_history ON SCHEDULE EVERY 1 MONTH STARTS '2026-09-01 03:00:00' DO OPTIMIZE TABLE order_history;- 이유: 이벤트는 실패해도 알림이 없고(
information_schema.EVENTS나 에러 로그를 직접 봐야 한다), 긴 쿼리가 돌고 있어도 무조건 정시에 돈다 - 문제: 긴 쿼리와 겹치면 메타데이터 잠금 대기가 쌓인다. 외부 배치는 실패 알림·재시도와 “긴 쿼리 없는지 확인 후 실행” 같은 사전 점검을 붙일 수 있다
- 참고:
OPTIMIZE TABLE은 binlog로 복제돼 복제본도 같은 재생성을 수행한다. 이벤트 자체는 복제본에서SLAVESIDE_DISABLED로 비활성이다
- 이유: 이벤트는 실패해도 알림이 없고(
-
-
-
트랜잭션 경계는 어떻게 잡나
- 함께 성공하거나 함께 실패해야 하는 변경만 한 트랜잭션에 묶는다. 외부 API 호출·파일 I/O·알림 발송은 밖으로 뺀다 — 외부 응답이 느리면 그 시간만큼 DB 커넥션과 잠금을 쥐고 있게 되고, 외부 실패가 DB 롤백까지 끌고 간다.
- 스프링이라면
@Transactional범위를 좁게 잡고, 조회 → 긴 처리 → 저장 흐름이면TransactionTemplate으로 저장 구간만 감싼다. - 커밋 이후 실행은
@TransactionalEventListener(phase = AFTER_COMMIT)을 쓴다. 커밋됐는데 후속 작업이 실패하면 유실되므로, 유실이 허용되지 않으면 같은 트랜잭션에서 이벤트를 테이블에 저장하고 별도 프로세스가 발행하는 아웃박스 패턴을 쓴다.
-
단건 쿼리에도
@Transactional이 필요한가- InnoDB는 autocommit이 기본이다 — 문장 하나가 그 자체로 트랜잭션이라, 트랜잭션 없이 실행되는 SQL은 없다
- JPA는 다르다 —
executeUpdate()(Spring Data JPA의@Modifying포함)는 트랜잭션이 없으면TransactionRequiredException을 던진다 - JdbcTemplate이나 MyBatis로 짠 코드라면 없어도 되고, JPA
@Modifying이라면 반드시 붙여야 한다
-
readOnly = true는 실제로 뭘 하나- Spring은 두 가지를 한다 — JDBC 커넥션에 read-only 힌트를 주고, Hibernate의 flush를 생략한다
- MySQL은 여기에 더해 read-only 트랜잭션에 트랜잭션 ID(TRX_ID) 할당을 생략한다 — 힌트가 아니라 실제 최적화다
다음 주 Try
- test 환경에
MALLOC_ARENA_MAX=2와 jemalloc(background_thread:true)을 순차 또는 파드 분리로 배포해, 운영급 트래픽에서 격차 추세와 응답 지연/처리량 비교하기 - 『주니어 백엔드 개발자가 반드시 알아야 할 실무지식』 4장 읽고 정리하기