3줄 요약
- 6월 장애 후속조치로 JVM RSS와 NMT 사이 1.2GB 격차를 추적했다.
- “잔류 단편화 1.1GB” 가설은 규모가 틀렸다. 운영 trim으로 회수된 잔류는 0.2GB, 나머지 1GB는 살아있는 메모리였다.
- 다음 주는 jemalloc 프로파일링으로 살아있는 1GB의 출처를 확인한다.
지난주 Try 점검
- 6월 장애 후속조치 — 남은 메모리 요인 특정 (상시 과제, 계속) → 아직 못 잡았다. 대신 가설에서 맞는 부분과 틀린 부분을 갈랐고, 후보를 셋으로 좁혔다. 이번 주 본문.
이 형식의 첫 회고라 점검할 Try는 위 상시 과제 하나다.
이번 주의 문제: 힙은 2GB인데 RSS는 3.7GB, 나머지는 누가 쓰나
상황
6월 장애 때 인스턴스 두 대 중 한 대가 죽고, 요청이 남은 한 대로 몰리며 메모리를 100%까지 쓰는 일이 있었다. 남은 한 대가 요청을 다 받아냈고, 기능별 성공률은 유지됐다. 사용자 영향이 없었던 게 다행이었다. 죽은 이유를 파보니 메모리였다. 힙과 메타스페이스는 정상인데, 힙 밖 네이티브 영역이 과할당되며 컨테이너 limit에 닿아 OOMKill로 재시작되는 상황이었다.
당시 추적으로 원인 하나는 잡았다. MultipartFile#getBytes()였다. 테스트 환경에서 다이렉트 메모리 한도를 일부러 50MB로 조여(-XX:MaxDirectMemorySize=50m) OOM을 재현했다. 필요한 숫자는 에러 메시지에 다 있었다.
OutOfMemoryError: Cannot reserve 6346143 bytes of direct buffer memory
                  (allocated: 47286469, limit: 52428800)
이미 스레드들이 쥐고 있던 캐시 45.1MiB에 새 PDF 버퍼 6.05MiB가 더해져 50MiB 한도를 넘었다. 할당이 어디서 일어났는지는 스택트레이스에 그대로 남아 있었다.
PdfService.chat()
 └ StandardMultipartFile.getBytes()
   └ ChannelInputStream.readAllBytes()
     └ FileChannelImpl.read(힙 버퍼)
       └ IOUtil.read
         └ Util.getTemporaryDirectBuffer
           └ Bits.reserveMemory → OutOfMemoryError
동작을 뜯어보면 이렇다. getBytes()는 업로드된 PDF를 힙 byte[]로 한 번에 통째로 읽는다. 그런데 NIO는 힙 배열을 시스템콜에 직접 넘길 수 없어서, 읽기 요청과 같은 크기의 임시 다이렉트 버퍼를 만들어 경유시킨다. 6MB PDF를 읽으면 6MB 다이렉트 버퍼가 생긴다.
- 무엇인가 — JVM 힙 밖의 네이티브 메모리에 할당되는 버퍼다(
ByteBuffer.allocateDirect). - 왜 쓰는가 — 커널은 GC가 주소를 옮길 수 있는 힙 배열을 직접 읽고 쓸 수 없다. 주소가 고정된 다이렉트 버퍼가 시스템콜의 경유지가 된다.
- 어떻게 동작하는가 — 힙 버퍼로 읽기를 요청해도 NIO가 내부에서 같은 크기의 임시 다이렉트 버퍼를 만들어 커널 → 다이렉트 → 힙 순서로 복사한다.
- 어떤 문제가 생기는가 — 힙 밖이라
-Xmx가 아닌 별도 한도(MaxDirectMemorySize)를 따르고, 힙 사용량 그래프에 잡히지 않는다. 힙은 멀쩡한데 컨테이너 메모리가 차오르는 문제의 단골 영역이다.
문제는 이 버퍼가 사용 후 해제되지 않고 스레드 로컬 캐시에 반납된다는 것이다. 기본 설정에는 이 캐시의 크기 상한이 없어서, 큰 파일을 한 번이라도 읽은 워커 스레드는 그 크기의 버퍼를 계속 쥔다. 톰캣 워커 스레드는 풀에서 죽지 않으니 회수될 시점도 없다. 결국 워커 스레드 수 × 각자 읽어본 최대 파일 크기만큼 다이렉트 메모리가 계단식으로 쌓였다.
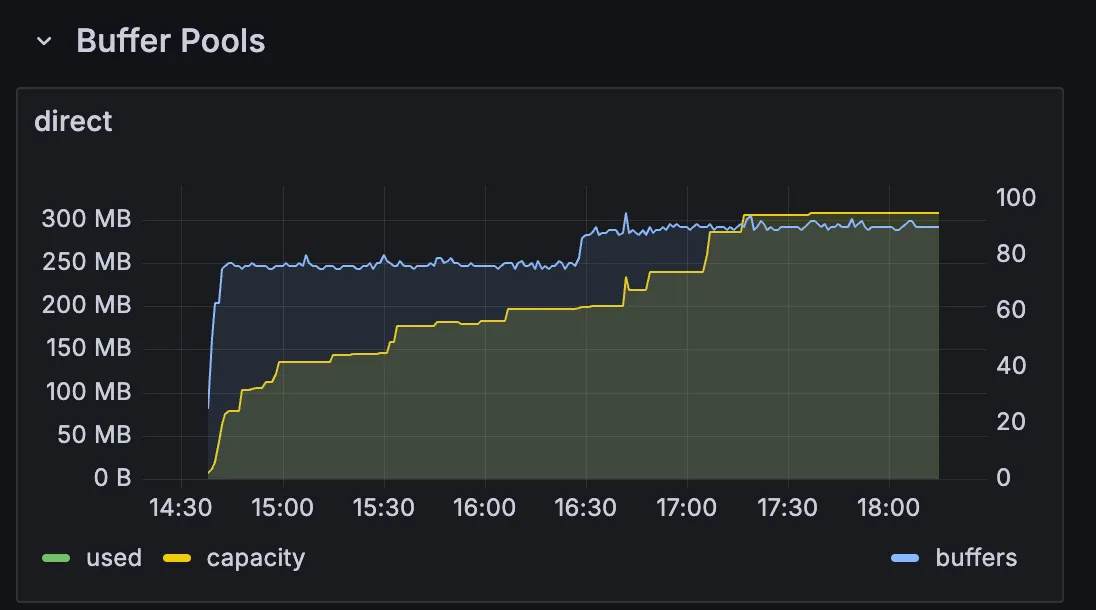
빠른 대응이 필요했다. 코드를 고쳐 배포하는 대신 JVM 옵션 한 줄로 축적을 끊었다.
-Djdk.nio.maxCachedBufferSize=262144256KB보다 큰 임시 다이렉트 버퍼는 캐시에 반납하지 말고 즉시 해제하라는 설정이다. 소켓 I/O 같은 작은 버퍼의 재사용 이득은 유지하면서, 수 MB짜리 PDF 버퍼만 캐시에서 배제한다.
이 값이 작동하는 지점은 JDK 소스(sun.nio.ch.Util)에 있다. 사용이 끝난 임시 버퍼는 isBufferTooLarge, 즉 maxCachedBufferSize 초과일 때만 즉시 해제되고, 그 외에는 전부 스레드 캐시로 돌아간다. 기본값은 무제한이라 6MB 버퍼도 캐시행이다.
static void offerFirstTemporaryDirectBuffer(ByteBuffer buf) {
    if (isBufferTooLarge(buf)) {
        free(buf);
        return;
    }
    BufferCache cache = bufferCache.get();
    if (!cache.offerFirst(buf))
        free(buf);
}
테스트 환경에서 적용 직후 상승이 멈추는 걸 확인하고 배포했다.
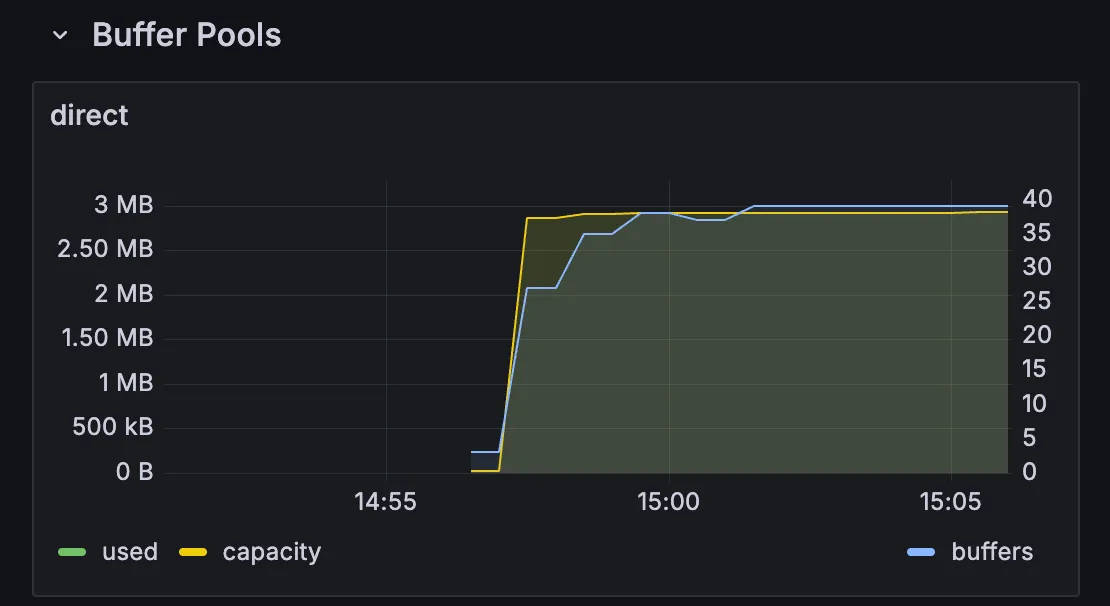
물론 공짜는 아니다. 큰 읽기마다 할당과 해제를 반복하는 비용이 생기고, 축적만 끊을 뿐 통째 읽기 자체가 사라지는 건 아니라서 근본 해결(스트리밍 교체)은 후속 과제로 남겼다.
이 조치로 OOMKill 주기가 1일에서 5일로 늘었다. 하지만 여전히 5일마다 죽는다는 건 다른 요인이 있다는 뜻이었다. 지금 운영 파드 RSS는 limit 4GB의 93%다. 힙은 2GB인데, JVM이 스스로 아는 메모리(NMT committed 2.5GB)와 실제 RSS(3.7GB) 사이에 1.2GB 격차가 있다. 이 1.2GB의 정체를 밝히는 게 이번 주 과제였다.
시도
- 가설 수립 — glibc malloc arena 단편화. 당근 기술 블로그 글에서 “JVM 메이저 버전을 올린 직후 서버가 몇 시간 주기로 죽는” 사례를 읽고 같은 메커니즘을 의심했다. 실제로 pmap에 64MB 정렬 arena 서브힙 37개, 1.3GB가 잡혔다.
- 재현 성공. glibc malloc을 직접 호출하는 재현기를 만들었다. 스레드 24개로 malloc/free를 반복시키자 30초 만에 RSS가 137MB에서 1,441MB로 계단식 상승했다. 운영과 같은 패턴이다. 서브힙 판별 기준도 운영 pmap 분석과 동일하게 맞췄다.
- 정석 처방 실패.
MALLOC_ARENA_MAX=2를 재현기에 걸었다. 서브힙은 24개에서 3개로 줄었는데 총 RSS는 44% 늘었다. 할당이 main arena로 몰리며 arena당 단편화가 악화된 것. 카나리 실측 없이 운영에 걸었다면 역효과였다. 운영 적용도 보류했다 — arena 수는 이미 상한(8×코어=32)에 도달해 증식이 멈춰 있었고, 줄일 수 있는 잔류가 0.2GB뿐인 데다, 줄여봤자 살아있는 1GB에는 효과가 없어서다. - 가설 검증 — 절반만 맞았다.
jcmd System.trim_native_heap을 테스트에서 안전성 확인 후 운영 두 대에 실행했다. 회수는 각각 207MB, 96MB. 두 번째 trim은 0. 잔류는 실재했지만 0.2GB뿐이었다. 나머지 1GB는 반환을 못 하는 게 아니라 실제로 살아서 쓰이고 있다는 뜻이다. “잔류 1.1GB” 가설은 방향이 아니라 규모가 틀렸다. - 후보 배제. 남은 의심 후보였던 direct buffer는 JMX 지표(40MB)와 NMT Other 영역 교차 확인으로 제외했다. 6월에 남긴 기록 덕에 몇 분이면 충분했다.
해결
근본 원인은 아직 못 잡았다. 대신 RSS 3.7GB가 어디에 얼마씩 쓰이는지는 확정됐다.
trim 전후의 pmap 대조가 결정적이었다. 64MB 서브힙의 가상 크기(Kbytes)는 그대로인데 RSS만 8K로 떨어졌다. 통째로 free 상태였던 서브힙을 trim이 커널에 반환했다는 뜻이고, 테스트에서 봤던 시그니처가 운영 스케일로 재현된 것이다. 회수분 207MB의 대부분이 이런 서브힙 두 개에서 나왔다.
0x7a07e8000000   65516K rw   RSS      8K    (trim 전 RSS 65,516K)
0x7a0850000000   65536K rw   RSS 17,592K    (trim 전 RSS 65,536K)
반대로 trim 후에도 arena에는 약 1.3GB가 남았고, 두 번째 trim은 320KB밖에 걷지 못했다. 이 1.3GB는 반환 불가능한 메모리로 확정됐다 — 살아있는 네이티브 할당, 그리고 페이지 안에 live와 free가 섞여 trim이 돌려줄 수 없는 미세 단편화다. NMT가 추적하는 malloc은 220MB뿐이니, 약 1GB가 NMT 밖에서 살아있는 셈이다.
RSS 3.7GB = 힙 2.05GB (한 파드는 풀커밋 — 이후 RSS 증가는 전부 네이티브 쪽)
          + 살아있는 네이티브 ~1.3GB (그중 NMT 밖 ~1.0GB ← 진짜 조사 대상)
          + 회수 가능 잔류 ~0.2GB (변동 — trim으로 상시 억제 가능)
잔류 0.2GB는 -XX:TrimNativeHeapInterval(JDK 21.0.3+, JDK-8325496)로 상시 억제할 수 있다. 남은 1GB의 후보는 혐의 순으로 넷이다.
- BoringSSL(netty tcnative) — TLS 커넥션마다 세션 상태와 암호화 버퍼를 순수 C malloc으로 잡는다. NMT에 전혀 안 잡히고, gRPC·OTLP·MySQL TLS까지 오래 사는 커넥션이 많다.
- quiche(QUIC/HTTP3) — 재전송 버퍼를 유저스페이스에서 관리해 커넥션당 버퍼가 TLS보다 크다.
- zlib 스트림 누수 — close 안 된 Inflater/Deflater가 개당 50~100KB의 네이티브 상태를 쥔다. GZIP·압축 처리의 고전 누수.
- 미세 단편화 — 4KB 페이지에 live 100바이트와 free 3.9KB가 섞이면 trim이 못 돌려주고 pmap엔 통째로 RSS로 잡힌다.
질문이 “잔류가 왜 많지”에서 “NMT에 안 잡히는데 살아있는 1GB는 누구지”로 바뀌었다.
배운 것
정석 처방도 워크로드를 탄다. 튜닝 플래그는 카나리에서 실측한 뒤에만 건다. 가설이 빗나가면 아쉬워하는 대신, 맞은 부분과 틀린 부분을 가르고 질문을 다시 정의한다. 그리고 재현 실험이 재미있어서 몇 초짜리 저비용 확인을 뒤로 미뤘다 — 다음 조사는 5분 확인 목록부터 만들고 들어간다.
다음 주 Try
- 테스트 환경에 jemalloc 프로파일링(
LD_PRELOAD)을 배포해 살아있는 1GB의 할당 스택 확인하기. jemalloc은 미세 단편화도 완화하니, 프로파일 결과와 무관하게 RSS가 떨어진다면 그 자체로 미세 단편화가 답이었다는 확인이 된다.