이번 주 요약
기록 기간: 2026년 9월 14일 ~ 9월 20일
이번 주에는 로그가 사라지는 조건을 시험했다. 출시 전에는 30시간 동안 서비스를 실행했고, 출시 후에는 실제 응답 속도를 확인했다. 출석 달력에서 이전 기간의 기록을 보여 주던 오류도 수정했다.
| 날짜 | 기록 | 확인한 내용 |
|---|---|---|
| 9월 14일 | 30시간 테스트와 로그 수집 개선 | 테스트 기간에 메모리 누수는 관찰되지 않았다. 로그 수집 경로를 통합하는 시험도 진행했다. |
| 9월 15일 | Fluent Bit 설정 정리 | 공통으로 쓸 규칙과 서비스별로 정할 설정을 정리했다. |
| 9월 16일 | 로그 유실 실험 | 로그를 파일에 남겨 두면 강제 종료 후에도 복구할 수 있었다. |
| 9월 16일 | 출석 달력의 날짜 계산 오류 수정 | 리워드를 연장한 날과 다음 날에 보여 줄 출석 기록을 나눠 확인했다. |
| 9월 17일 | 출시 후 성능 확인 | CPU 사용률과 6개 API의 응답 시간을 확인했다. |
주제 1 : 로그 수집 — 전송에 실패한 기록을 복구할 수 있게 하기
목적: 로그 수집 경로를 줄여 관리하기
통계 로그를 모으는 경로를 하나로 통합하는 시험을 진행했다. 기존에는 서비스가 Splunk로 직접 보내는 방식과 파일을 따로 모아 보내는 방식이 섞여 있었다. 경로마다 설정과 저장 위치를 관리해야 해 부담이 컸다. (기존 수집 방식과 개선 기록)
기능: 로그를 목적지별로 보내고, 실패한 기록은 보관하기
로그를 목적지별로 보내는 AWS 기능인 FireLens를 시험하고 있다. 이 안에서 로그 수집 프로그램인 Fluent Bit이 전송을 맡는다.
- 통계 로그: Splunk로 보낸다.
- 일반 로그: 기존 CloudWatch로 보낸다.
전송이 끊기면 로그를 임시로 보관할 공간이 필요하다. 이 공간을 버퍼라고 한다. 9월 16일에는 내 컴퓨터에서 전송 실패와 강제 종료를 일으켜, 보관한 로그를 나중에 보낼 수 있는지 확인했다. (수집 구성과 실험 기록)
처리: 파일 보존과 종료 순서를 나눠 확인하기
파일을 남겨 두면 강제 종료 후에도 복구할 수 있었다. 저장 방식을 나눠 비교했다.
- 메모리에 보관: 강제 종료 후 로그 1,000건이 모두 사라졌다.
- 파일에 보관: 같은 폴더를 연결해 다시 실행했다. 전송을 복구한 뒤 1,000건을 모두 받았다.
실험 조건과 확인 방법은 다음과 같다. (실험 조건과 결과)
- 환경: Fluent Bit 1.9.10과 내 컴퓨터에 띄운 수신 서버를 사용했다.
- 반복: 조건마다 로그 1,000건을 넣고 세 번씩 시험했다.
- 확인: 로그의 고유 번호인
event_id를 비교해 빠지거나 중복된 기록을 셌다.
파일에 보관해도 로그가 사라지는 조건은 있었다.
- 재시도 횟수 소진: 정해 둔 횟수만큼 다시 보내도 실패하면 로그가 삭제됐다.
- 저장 공간 부족: 공간이 가득 차면 오래된 로그부터 삭제됐다.
- 파일 저장 한도를
1M으로 두고 무제한 재시도한 결과: 1,000건 중 200건을 받았고, 800건이 사라졌다. - 세 번 모두 같은 결과였고 중복은 0건이었다. 삭제 건수 지표인
dropped_records는 0으로 나왔다. 이 실험에서는 지표만 보고 로그 유실을 알 수 없었다.
서비스가 끝날 때는 마지막 로그까지 보낼 시간이 필요하다. AWS의 서비스 실행 환경인 ECS에 적용할 종료 순서와 대기 설정도 정리했다.
애플리케이션을 먼저 종료하고, FireLens는 나중에 종료한다. (AWS의 FireLens 종료 순서)
- 애플리케이션 종료 중: 마지막 로그를 남긴다. FireLens는 수집을 계속한다.
- 애플리케이션 종료 후: FireLens가 종료 신호를 받고 남은 로그를 보낸다.
전송을 기다리는 시간은 두 설정으로 나눈다. stopTimeout은 Grace보다 길게 잡는다.
- Fluent Bit의
Grace: 남은 로그를 보낼 시간이다. - ECS의
stopTimeout: 강제로 종료하기 전까지 기다릴 시간이다.
예를 들어 Grace를 90초, stopTimeout을 120초로 둘 수 있다. 이 시간은 설정 예시다. Fargate에서 stopTimeout은 최대 120초까지 지정할 수 있다.
종료할 때도 전송 대상에 장애가 남아 있으면 로그를 다 보내지 못할 수 있다. Fargate의 실행 단위인 태스크가 끝나면 임시 저장 공간도 삭제된다. 원본을 태스크 밖에 보관하고 다시 보낼 방법도 필요하다.
확인한 결과와 남은 과제를 구분했다.
- 확인한 결과: 내 컴퓨터에서 파일을 보존한 뒤 로그를 복구했다.
- 남은 과제: 실제 환경에서 ECS 종료 설정과 원본 재전송 방법을 확인한다.
주제 2 : 출시 전후 검증 — 30시간 테스트 후 실제 응답 속도 확인하기
목적: 새 기능을 출시하기 전에 성능 확인하기
출석 기능을 출시하기 전에 부하테스트를 진행했다. 요청을 보내며 처리 속도를 확인하는 테스트다. 지난주에는 DB 연결 수와 서버의 처리 자원을 조정해 응답 지연을 줄였다.
기능: 오래 실행해도 응답 속도가 유지되는지 보기
이번에는 같은 설정으로 30시간 동안 요청을 처리하게 했다. 이렇게 오래 실행하며 상태를 확인하는 시험을 soak test라고 한다. 다음 두 항목을 함께 살폈다. (30시간 테스트 기록)
- 응답 시간: 요청을 처리하는 데 걸린 시간.
- 메모리 상태: 자바 프로그램의 실행 환경인 JVM에서 메모리 누수가 관찰되는지.
확인 방법과 결과: 테스트 중 측정하고, 출시 후 다시 측정하기
테스트 중 일부 요청에서 순간적인 지연이 있었다. 그래프에서는 최대·최소 응답 시간과 함께 p90·p95를 확인했다. p90·p95는 해당 구간에서 요청의 90%·95%가 처리된 시간을 뜻한다.
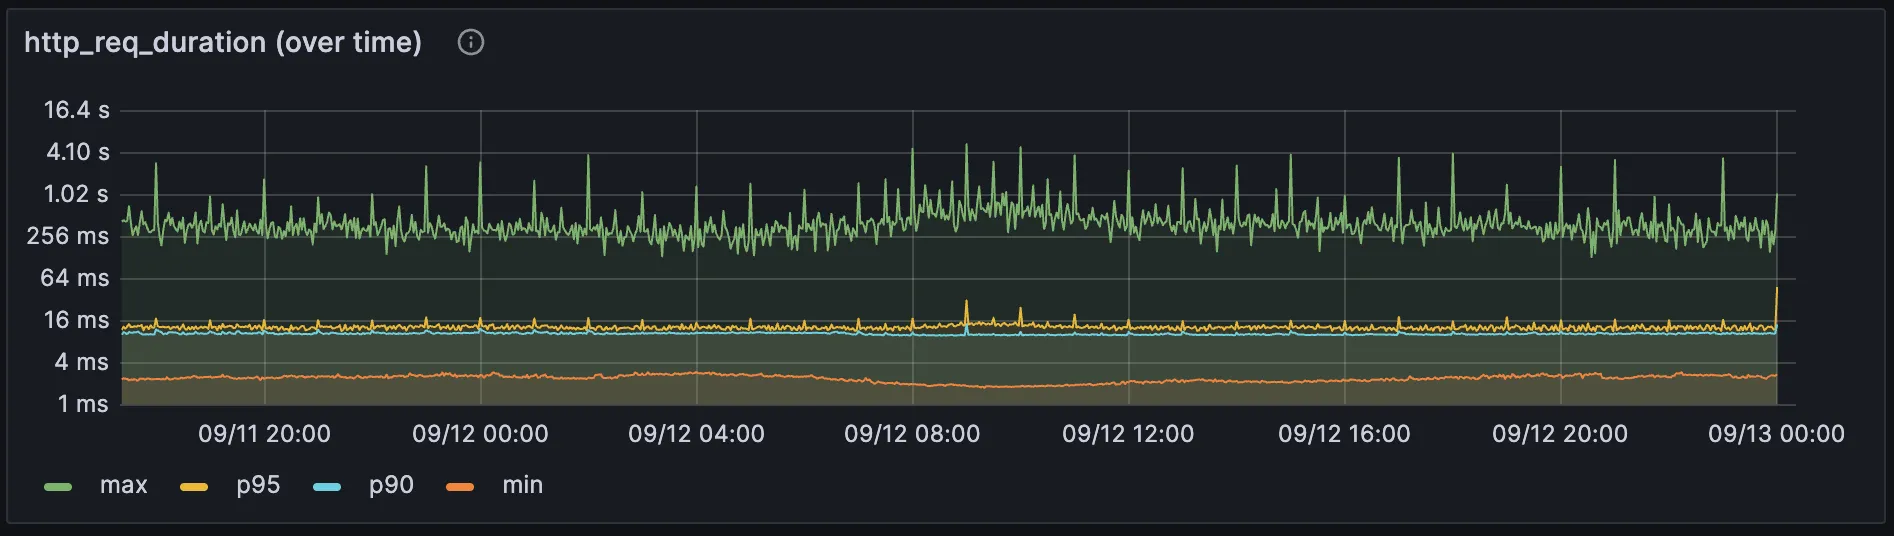
- 응답 시간: 그래프의 구간별 p90·p95는 대부분 16ms 아래를 유지했다.
- 메모리: 30시간 동안 JVM 메모리 누수는 관찰되지 않았다.
이 결과를 확인하고 테스트를 마쳤다. 출시 후에는 실제 서비스의 CPU 사용률과 API 응답 시간을 측정했다. API 응답 시간은 앱의 요청에 서버가 답하기까지 걸린 시간이다. (출시 후 측정 기록)
- 9월 17일 기록의 06 ~ 18시 CPU 사용률: 약 26% 이하, 오전 9시대 약 26%에서 18시 무렵 약 9%로 감소.
- 같은 기록에 정리한 6개 API: 평균 응답 시간 2 ~ 24ms, p95는 모두 48ms.
주제 3 : 출석 테스트 — 리워드 연장 후 잘못 나온 달력 수정하기
목적: 리워드를 연장한 뒤에도 출석 기록을 맞게 보여 주기
리워드를 연장한 뒤 달력에 이전 기간의 출석 기록이 나오는 오류를 수정했다. 리워드를 받거나 연장할 때 쓰는 출석 기간을 회차라고 한다. 연장한 날에는 방금 마친 회차의 기록을 보여 줘야 한다. (오류 상황과 출석 규칙)
기능: 연장한 날에는 완료한 기록, 다음 날에는 새 달력 보여 주기
9월 15일에 리워드를 연장했다. 달력에는 9 ~ 15일 기록이 나와야 했지만, 2 ~ 8일 기록이 나왔다.
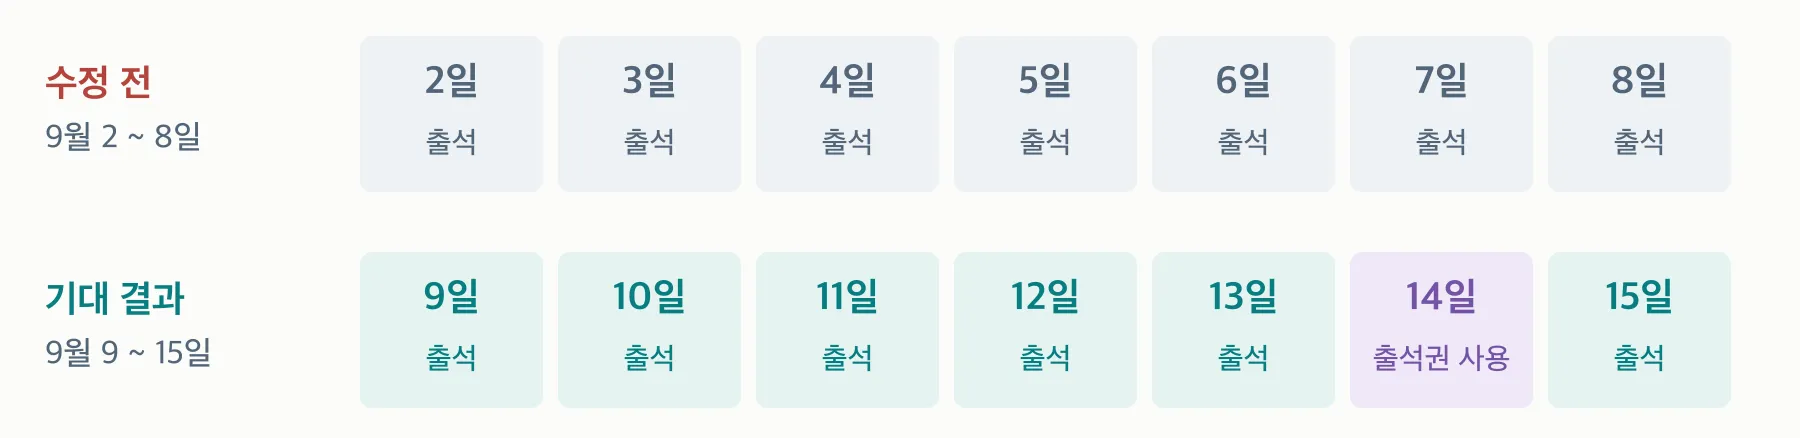
수정 후에는 연장한 날과 다음 날을 나눠 확인했다.
- 9월 15일, 연장 직후: 9 ~ 15일의 출석 기록을 유지한다. 14일에 쓴 자동 출석권 표시도 유지한다.
- 9월 16일, 첫 출석 전: 새 회차의 빈 달력을 보여 준다. 출석 일수는 0일이다.
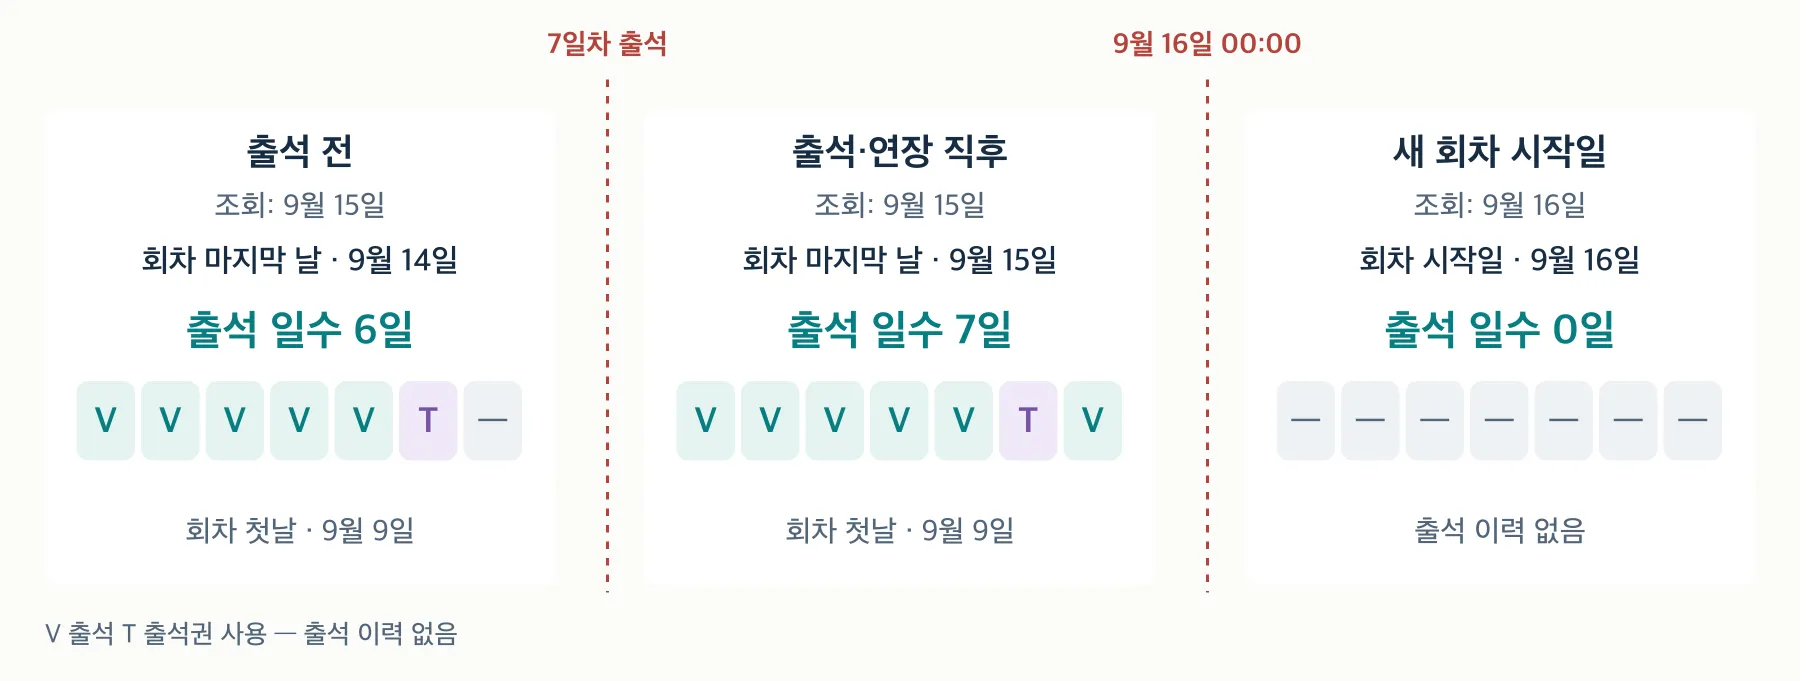
처리: 이번 회차의 시작일 이후 기록만 가져오기
기존 코드는 가장 최근의 연장 기록만 확인했다. 그보다 앞서 리워드를 받은 기록을 놓쳐 이번 회차의 시작일을 잘못 찾았다.
이번 회차의 시작일을 기준으로 기록을 가져오도록 바꿨다. (원인과 수정 방법)
- 리워드를 받은 기록과 연장한 기록을 함께 확인한다.
- 달력을 조회하는 날에 해당하는 회차를 찾는다.
- 그 회차의 시작일보다 앞선 출석 기록은 제외한다.
테스트에는 연장 직후와 다음 날 첫 출석 전의 달력을 추가했다. 확인 범위도 넓혔다. (추가한 테스트와 결과)
- 리워드: 의도대로 연장되는지 확인했다.
- 달력: 날짜와 출석권 사용 표시가 맞게 나오는지 확인했다.