오늘 읽은 책
『다시, 소프트웨어 엔지니어』 (교보문고)
오늘 읽은 범위
- 1장: 프로그래머에서 이제는 엔지니어로 (p.37~51)
기억하고 싶은 내용
- 다양한 명칭으로 불리는 엔지니어
- 소프트웨어 엔지니어는 코드를 능숙하게 작성하는 것을 넘어 확장성, 신뢰성, 효율성, 보안까지 고려한다.
- 알고리즘과 설계를 피상적으로 이해하는 수준을 넘어 규칙을 알 뿐만 아니라 언제 그 규칙을 유연하게 적용하고 깨뜨려야 하는지 이해한다.
- 기초의 중요성
- 타인이 작성한 코드를 읽고 새로운 코드를 빠르게 이해하는 법을 배워야 한다. 익숙하지 않은 코드는 위협적으로 느껴질 수 있지만, 모호함에 익숙해질 필요가 있다. 수개월이 지나도 코드 모든 뉘앙스 이해하지 못하는 것은 자연스러운 일이고, 코드 변경 전에 모든 것을 파악하는 게 당연한 건 아니다.
- 교육받은 지식과 알아야 할 지식
- 기술적인 역량뿐만 아니라 협업 방법, 코드 읽는 방법, 쉬운 코드 작성 방법, 레거시 코드 효과적으로 다루는 방법도 알아야 한다.
- 현업은 레거시 코드를 다루는 데 대부분 할애한다. 또한 내가 합류하기 전 내려진 결정으로 인한 부담도 포함이다.
- 현업은 사업적 가치를 지속적으로 전달하기 위해 멈추지 않는 코드를 맞닥뜨리게 된다.
- 게으른 프로그래머 정신의 수용
- 주니어는 본능적으로 해결책 찾는데 급급하다. 문제 영역 고려할 시간도 갖지 않고 코드를 작성한다. 전략적으로 게으름 피워 생각할 시간을 확보하며 궁극적으로 생산성을 높이고 더 나은 해결 방안을 만들자.
- 브루트 포스마냥 무차별 대입은 경계하자. 그리고 빅오 표기법처럼 최상의 경우, 최악의 경우, 평균적인 경우를 고려해 그에 맞게 적절히 선택한다.
- 문제 찾기 전에 기존 해결책이 있는지 찾아보자. 바퀴 재발명 금지다. 대부분 같거나 유사한 문제를 겪은 사례가 분명히 있고 그에 따른 해결책이 있다. 적절한지 판단 후 사용 여부 결정하자.
- 새로운 시각의 가치
- 신입은 과거 결정에 얽매이지 않고 편견 없는 관점으로 과업을 바라본다. 신선한 시각은 혁신적인 해결책이 되거나 비효율성을 발견하거나 오래된 가정에 의문을 제기한다. 새로운 구성원은 침체된 프로젝트에 열정을 넣어 새로운 에너지와 참여를 유도할 수 있다.
- 다른 관점의 가치를 과소평가해서는 안 되며 상황이 왜 그런지 묻는 것을 머뭇거려서 안 된다. 이상하다면 팀 동료에게 설명 요청한다. 대부분 비효율적이지만, 관행으로 남아 있을 수 있다.
- 성급한 해결책 제시의 위험성
- 일시적인 해법은 당장의 문제를 해결해 주지만, 장기적으로는 더 많은 문제를 야기한다. 근래에는 문제 예방에 집중되는 패러다임이 있다. CI-CD로 이어가면서 작업마다 문제가 생기는지 체크하고, 문제가 생기더라도 빠르게 반영한다. 또한 TDD 바탕으로 조기에 식별하려고 노력도 했다.
- 오류는 보통 오해로 시작된다. 오해를 줄이기 위해서는 해결할 문제에 집중하는 것이다. 애플리케이션이 어떤 문제를 해결하는지, 맥락과 제약 조건은 무엇인지, 관련된 문제들은 무엇인지 문제 영역을 충분히 생각하자.
- 고객 요청의 이면에 있는 이유나 근본 원인을 파고들어야 한다. 고객이 요청한 것과 필요한 것은 다르기 때문이다. 고객 요청이 그들의 사업적 문제를 해결하는 것 사이 괴리가 존재할 수 있다.
- 소프트웨어의 황금률 적용
- 남에게 대접받고 싶은 대로 남도 대접하라
- 자신의 과업을 이어받을 개발자를 생각해 코드를 정돈해야 한다.
읽으며 든 생각
- 브루트 포스마냥 무차별 대입은 경계하자. 그리고 빅오 표기법처럼 최상의 경우, 최악의 경우, 평균적인 경우를 고려해 그에 맞게 적절히 선택한다.
내 일에 적용해 본다면
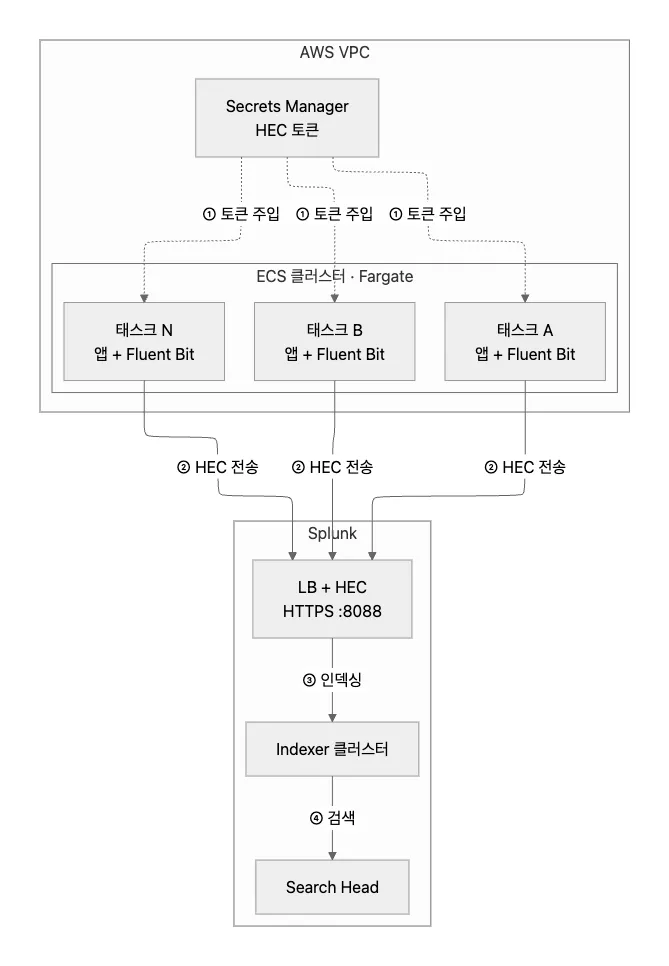
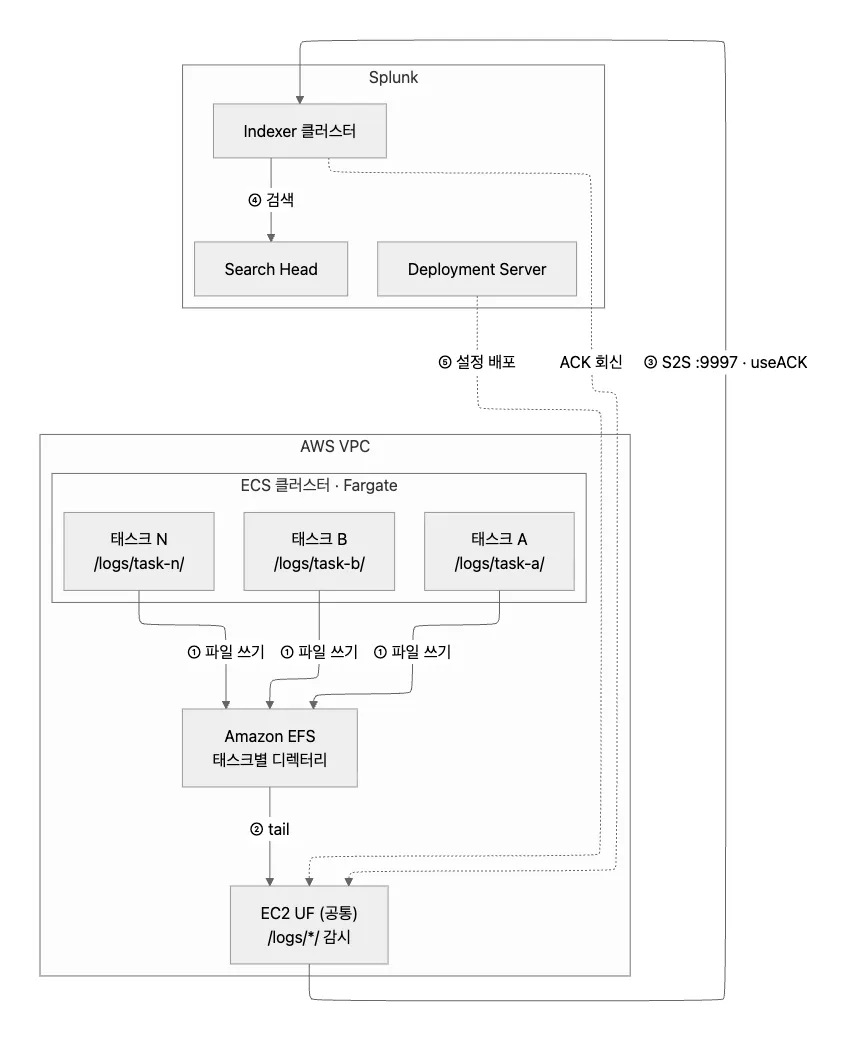
- 떠오른 상황: 서비스 로그를 Splunk로 보내는 방식을 정할 때. 9월 15일 낙서장에서 FireLens의 로그 유실을 실험했고, 기존에는 EFS에 쓴 로그 파일을 공통 EC2의 UF(Universal Forwarder)가 읽어 보내는 방식도 섞여 있다.
- 어떻게 하면 좋을까: 장점 하나만 보고 고르지 않는다. 최상·평균·최악의 경우로 나눠 비교하고, 최악의 경우를 감당할 수 있는 방식을 고른다.
로그 수집 방식 두 가지
| FireLens | EFS + 공통 UF |
|---|---|
 |  |
로그 수집 방식을 세 경우로 나눠 비교하기
| 경우 | FireLens | EFS + 공통 UF |
|---|---|---|
| 최상 | 앱은 stdout에만 쓰면 된다. 태스크끼리 격리돼 있어 한 서비스의 로그가 폭증해도 다른 서비스 로그는 늦어지지 않는다. | 파일이 EFS에 남고, UF가 ACK와 체크포인트로 이어서 보내 유실이 거의 없다. 설정은 Deployment Server에서 한 번에 바꾼다. |
| 평균 | 배포나 스케일인 때 종료 대기 시간이 짧으면 몇 초 분량이 유실될 수 있다. | 감시할 파일이 늘수록 적재가 늦어진다. 재전송 때문에 같은 로그가 두 번 들어올 수 있다. |
| 최악 | HEC 장애가 버퍼를 넘길 만큼 길어지면 넘친 로그가 버려진다. 피해는 로그에서 그친다. | EFS 처리량이 한계에 닿으면 앱의 로그 쓰기가 막혀 API 응답이 느려진다. 공통 UF가 막히면 모든 서비스의 로그가 늦어진다. |
| 최악 대응 | S3 출력을 함께 둔다. HEC 장애 중 버려진 로그를 S3에서 다시 적재할 수 있어, 유실은 버퍼에 남아 있던 양으로 줄어든다. | EFS를 Elastic 처리량 모드로 두고, 앱은 비동기로 로그를 쓴다. 로그가 많은 서비스는 UF를 따로 둔다. |
| 이 방식으로 보낼 로그 | 몇 초에서 몇 분 분량의 유실을 감수할 수 있는 로그 | 감사·정산 로그처럼 한 건도 잃으면 안 되는 로그 |
정리하자면
1장에서 기억하고 싶은 내용을 주제별로 묶으면 세 가지다.
| 주제 | 책의 주장 | 1장 소제목 |
|---|---|---|
| 엔지니어가 신경 쓰는 범위 | 코드를 잘 짜는 데서 그치지 않고 확장성, 신뢰성, 효율성, 보안까지 고려한다. 규칙을 알고, 언제 규칙을 유연하게 적용하거나 깨야 하는지도 판단한다. | 다양한 명칭으로 불리는 엔지니어 |
| 현업은 남이 짠 코드를 다루는 일이다 | 업무 시간 대부분이 레거시 코드와 내가 오기 전에 내려진 결정을 다루는 데 들어간다. 모든 코드를 이해하지 못한 채 수정하는 상황에 익숙해져야 한다. 다음 사람을 위해 코드를 정돈한다. | 기초의 중요성, 교육받은 지식과 알아야 할 지식, 황금률 |
| 코드를 쓰기 전에 문제부터 본다 | 바로 코드를 쓰지 말고 생각할 시간을 확보한다. 최상·평균·최악의 경우를 비교하고, 이미 있는 해결책부터 찾는다. 임시 해결책을 경계하고, 요청 뒤에 있는 실제 필요를 파악한다. 이상한 관행이 보이면 왜 그런지 묻는다. | 게으른 프로그래머, 성급한 해결책, 새로운 시각 |