ClickHouse 운영 적용을 위한 환경 준비
오늘 진행한 작업
- 통계 서버 모니터링 연결
- 최근 이틀치 로그 수집
- Vector 파일 탐색 주기 조정
- 월집계 추가
- 1년치 로그 백필 진행
운영 구성
기존 통계 서비스에 영향을 주지 않도록 로그 수집 경로에 Vector를 붙여 ClickHouse에 통계 데이터를 적재합니다.
모니터링이 연결되지 않아 디스크 여유 공간을 확인하지 못하는 문제
상황: 통계 서버에 시스템 모니터링이 없어 디스크 여유 공간과 사용량 추이를 확인할 수 없었습니다.
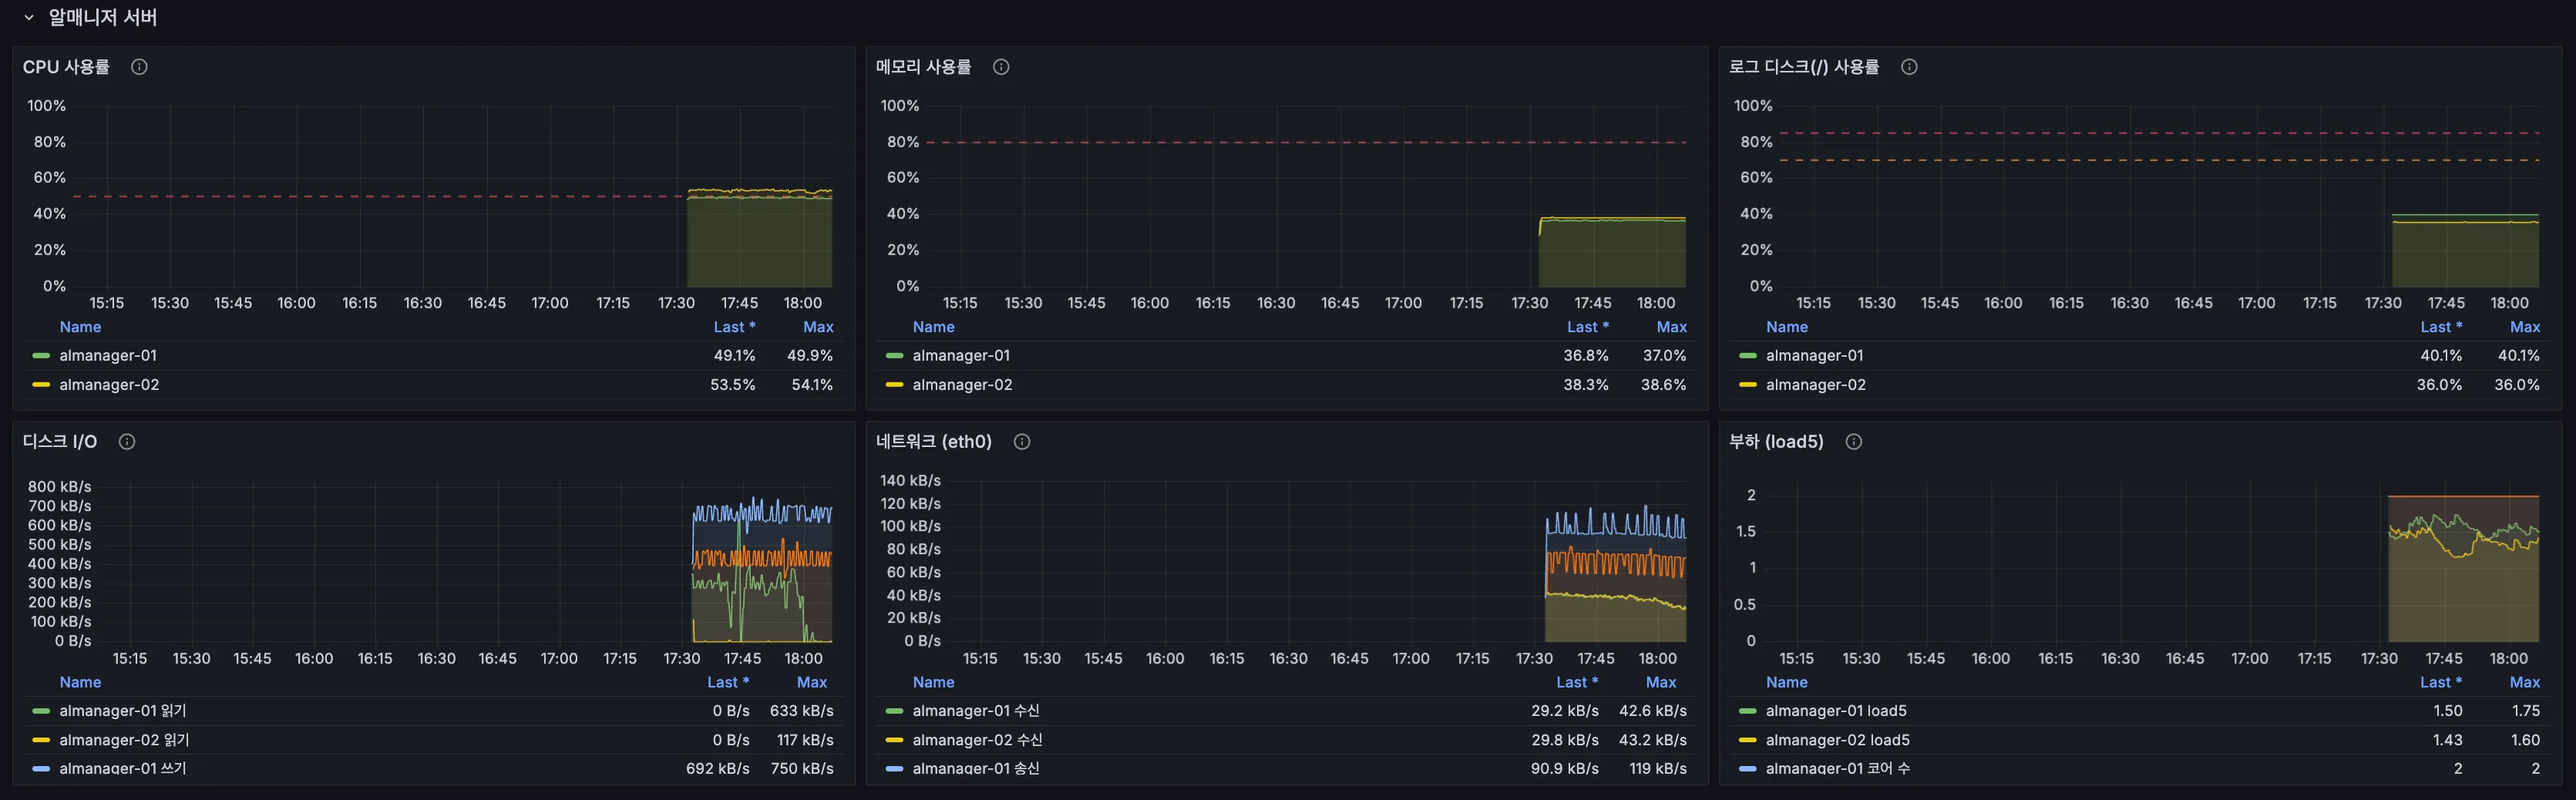
해결 과정: 각 서버에 Node Exporter를 추가하고 Vector → LGTM으로 메트릭을 연결했습니다. 대시보드에는 팀 SLO에 맞춘 기준선을 표시했습니다.
결과: 디스크와 CPU, 메모리를 함께 확인할 수 있게 됐습니다.
운영 부하를 고려해 로그 수집량을 조절해야 하는 문제
상황: 운영 부하를 줄이기 위해 최근 이틀치부터 수집하고, 나머지는 별도 백필로 채우기로 했습니다.
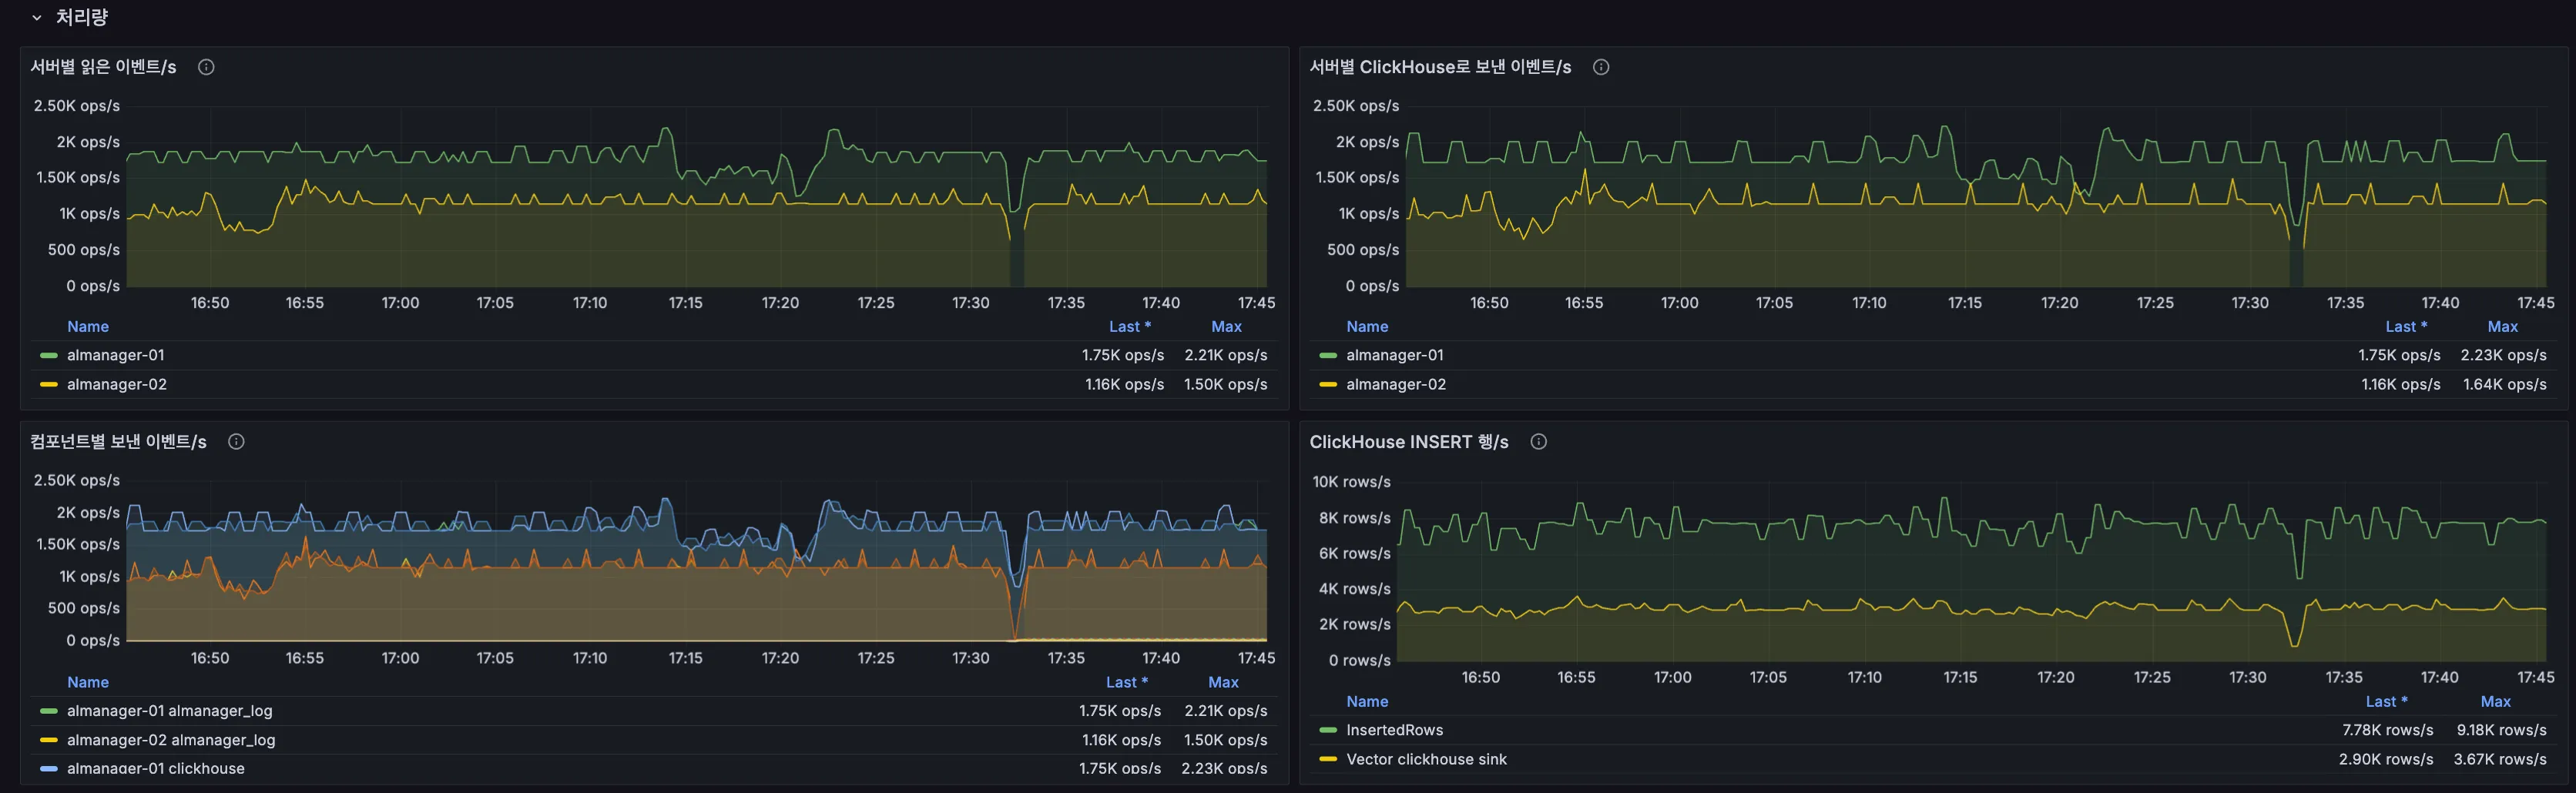
해결 과정: 기존 Vector 설정으로 수집을 시작했고, 처리량과 서버 부하를 보며 튜닝하고 있습니다.
- 전송 배치: 최대 50,000건, 압축 전 20MB, 대기 5초.
- 요청 동시성: 서버당 2개(
request.concurrency: 2). - 전송 압축: gzip.
결과: 초기 수집 처리량은 두 서버 합계 약 2,900건/s였습니다.
읽는 로그가 줄어도 system CPU가 줄지 않는 문제
상황: 서버 01의 읽기 속도가 67건/s로 줄었는데도 system CPU가 유지됐습니다. 약 3만 4천 개의 파일을 감시하고 있어 파일 탐색과 감시 비용을 원인 후보로 봤습니다.
해결 과정: 코드 수정 전에 옵션 변경만으로 효과를 확인하기 위해, 두 서버의 새 파일 탐색 주기를 기본 1초에서 15초로 늘렸습니다.
glob_minimum_cooldown_ms: 15000 # 새 파일 탐색 주기: 1초 → 15초결과:
| AS-IS: 새 파일 탐색 주기 1초 | TO-BE: 새 파일 탐색 주기 15초 |
|---|---|
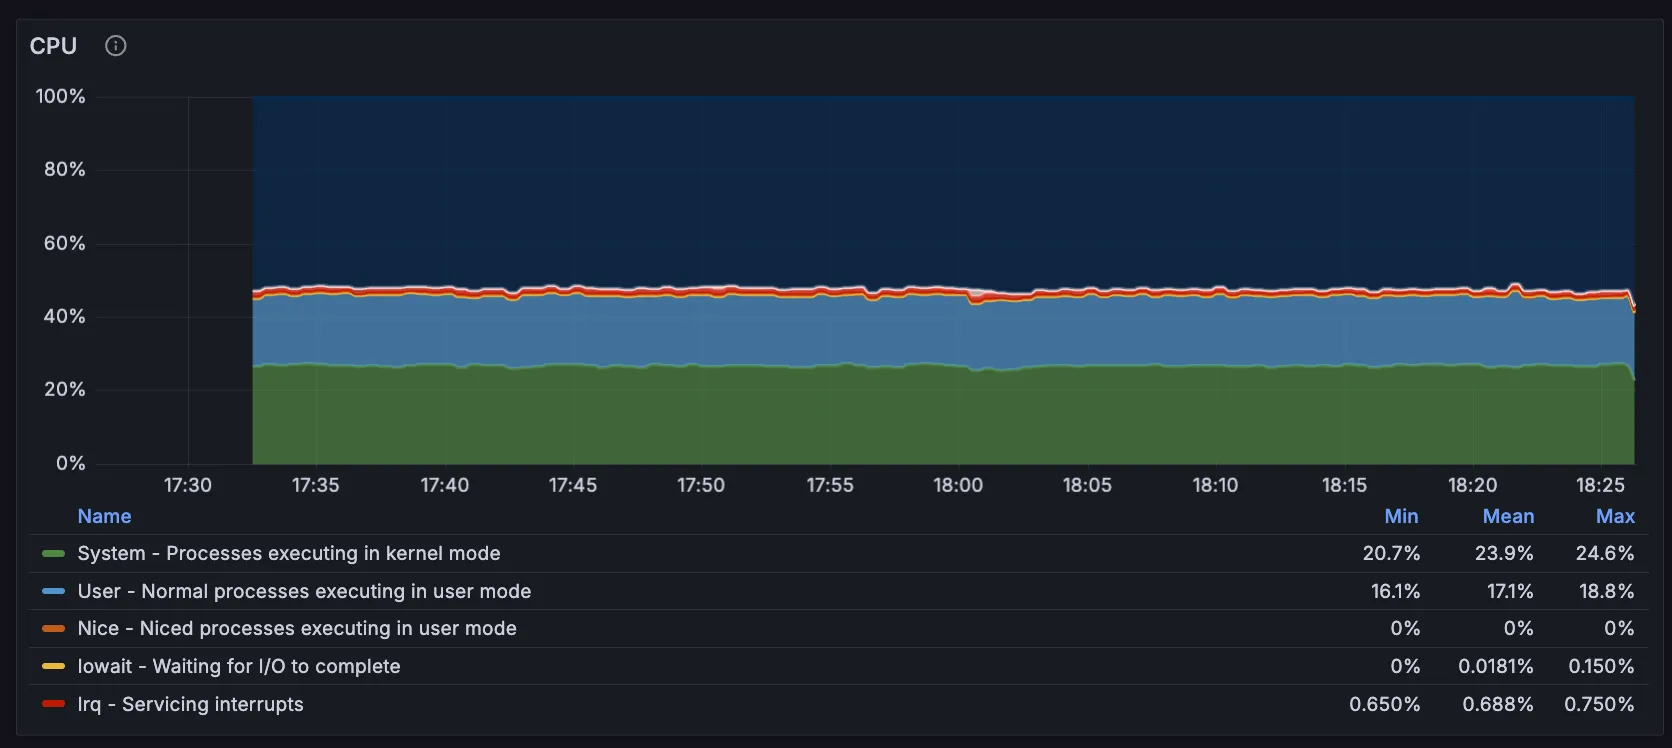 | 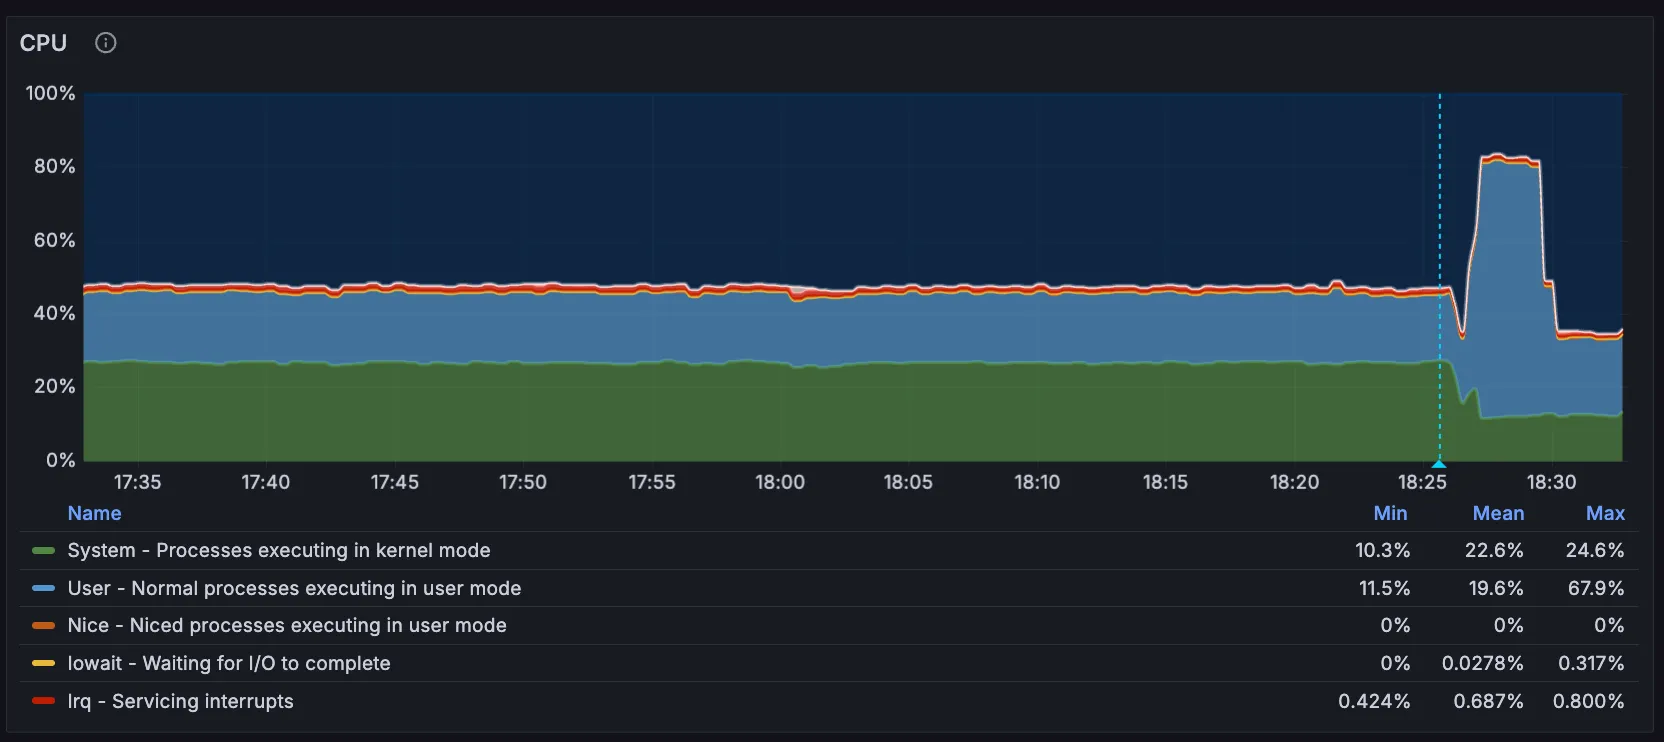 |
서버 01의 적용 전과 적용 후 20분 측정값입니다.
| 항목 | 적용 전 | 적용 후 |
|---|---|---|
| system CPU | 25.0% | 8.6% |
| 컨텍스트 스위치/s | 약 12.8만 회 | 약 4.3만 회 |
system CPU와 컨텍스트 스위치가 함께 줄어, 탐색 주기를 15초로 유지하기로 했습니다.
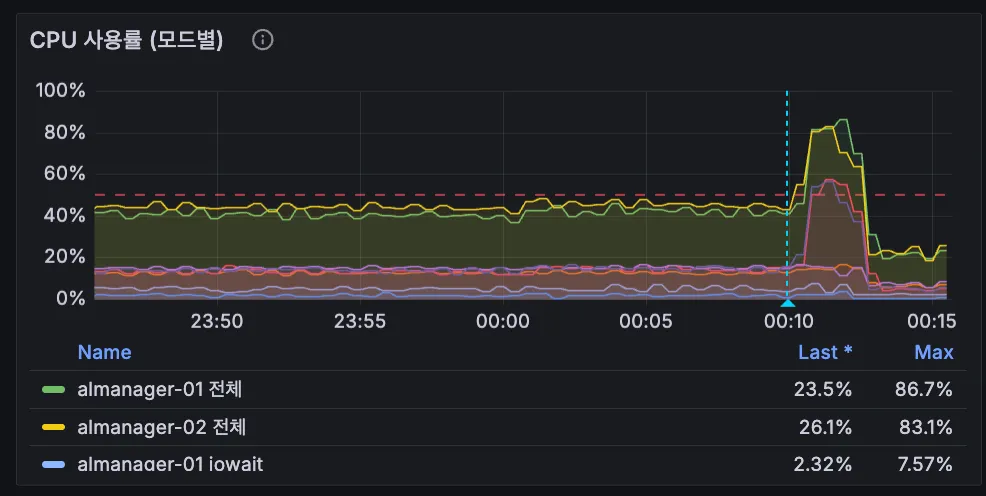
후속 이슈: 탐색 주기를 조정해도 로그 처리 시 CPU가 다시 높아져, 통계 서비스와의 CPU 경쟁을 줄이기 위해 데이타임 전에 개선해야 했습니다.
추가 조정:
- 감시 범위 갱신: 월 단위의
include범위를 크론으로 매일 갱신하고, 설정 검증 후 SIGHUP으로 재적용했습니다. - 갱신 실패 감지: 오늘 날짜와 수집 기간을 지속적으로 비교하고, 범위를 벗어나면 알림을 보내도록 구성했습니다.
결과: 열린 로그 파일이 약 3.4만 개에서 4,420개로 줄었고, Vector의 CPU와 메모리 사용량도 감소했습니다.
월집계 추가 시 기존분과 신규 적재가 중복 집계될 수 있는 문제
상황: 월집계 MV는 생성 이후 적재되는 데이터를 처리하므로 기존분은 별도로 채워야 했습니다. 그 사이 신규 적재가 겹치면 이중 집계될 수 있었습니다.
해결 과정:
| 순서 | 작업 |
|---|---|
| 1 | 통계 서버 01, 02의 Vector 중지. 이 구간에는 백필도 실행하지 않음 |
| 2 | 월집계 테이블과 MV 생성 → 기존분 적재 → 이벤트 수 검증 |
| 3 | 두 서버의 Vector 재시작 |
원본 이벤트 수와 월집계의 이벤트 수 합계를 비교했습니다.
SELECT
    (SELECT count() FROM almanager.events) AS events,
    (SELECT sum(events) FROM almanager.events_monthly) AS monthly;
결과: 기존분 적재와 총 이벤트 수 검증을 마치고 수집을 재개했습니다.
- 배운 점: 기존 데이터 재집계는 신규 적재와 분리해야 합니다.
- 확장 시 과제: Vector가 늘어나면 일괄 중지와 재개, 상태 확인의 자동화가 필요합니다.
백필 중 ClickHouse CPU와 /data 사용률이 높아지는 문제
상황: 두 통계 서버에서 1년치 로그 백필을 시작한 뒤 ClickHouse EC2의 CPU가 높아졌습니다.
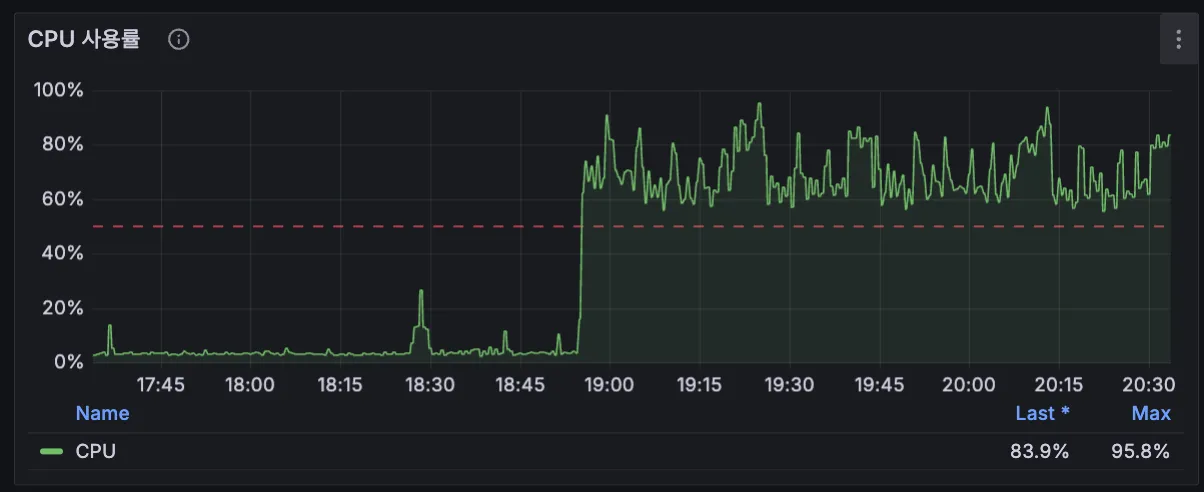
해결 과정: ClickHouse 내부 변환과 집계, 병합을 나눠 CPU 사용량을 측정했습니다.
- 작업 시간: 데이타임에 영향을 주지 않도록 저녁에 백필을 시작했습니다.
- 미완료 시 대안: 업무 시간 전 중지하고, 크론잡으로 야간에 나눠 적재할 계획을 세웠습니다.
결과 — 백필 마무리 단계:
| 항목 | 관측값 |
|---|---|
| 원본 로그 처리량(환산) | 약 22만/s |
| INSERT 지연, 거부, 실패 | 모두 0 |
최근 60초 동안의 INSERT와 병합 CPU 시간을 합산해 작업별 비중을 확인했습니다.
| 작업 | CPU 전체 비중 |
|---|---|
| INSERT 전체 (아래 세 줄 합계) | 69.0% |
└ JSON 파싱 (events_mv) | 44.0% |
| └ 원문 쓰기 등 (INSERT에서 MV 몫을 뺀 값) | 22.0% |
└ 월 집계 (events_monthly_mv) | 4.0% |
| 병합 (아래 세 줄 합계) | 31.0% |
└ raw_logs 병합 | 20.0% |
└ events 병합 | 9.0% |
└ events_monthly 병합 | 2.0% |
- JSON 파싱의 CPU 부담: 가장 큰 비중을 차지했습니다. 변환을 ClickHouse 외부로 옮겨 처리 부담을 나누는 것도 방법입니다.
- 원문 로그의 저장 공간: 내부 변환 시 원문과 변환 결과를 함께 저장하므로, 원문 로그의 TTL을 30일에서 7일로 줄였습니다.
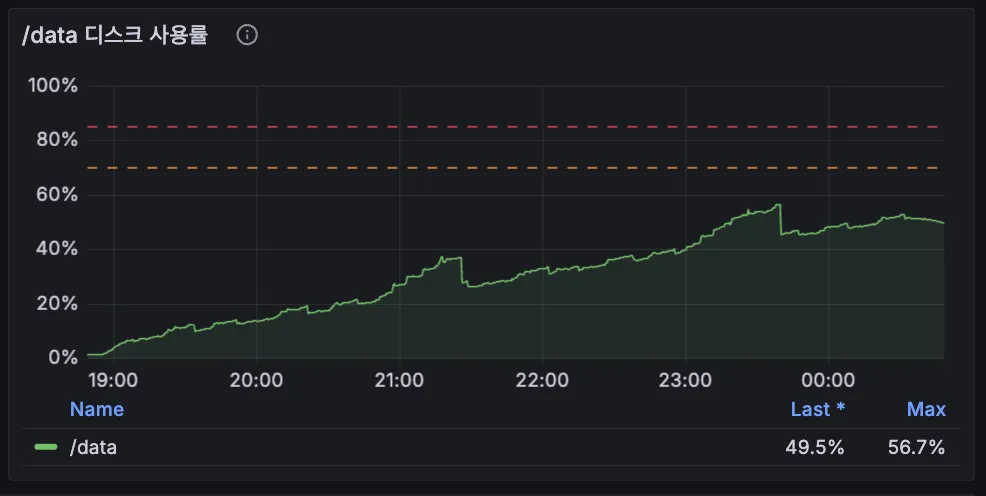
- 백필 마무리 단계의 디스크 사용량: 백필이 거의 끝나면서 디스크 증가세가 멈췄고, 병합이 진행되며
/data사용률은 최대 56.7%에서 49.5%로 낮아졌습니다. 사용률 70.0%를 백필 중지 기준으로 둔 모니터링은 유지합니다.