상황
사내 버셀을 LGTM에 연동하면서 서비스 상태를 확인할 대시보드와 alerts를 추가해보고 싶었습니다. 그런데 기존 대시보드에서도 Service Mesh가 표시되지 않는 경우가 있었습니다.
datasource 설정을 수정해야 했지만 UI에서 바꿀 수 없어 작업이 막혔습니다.
| 비어 있는 Service Mesh | 수정이 막힌 datasource 설정 |
|---|---|
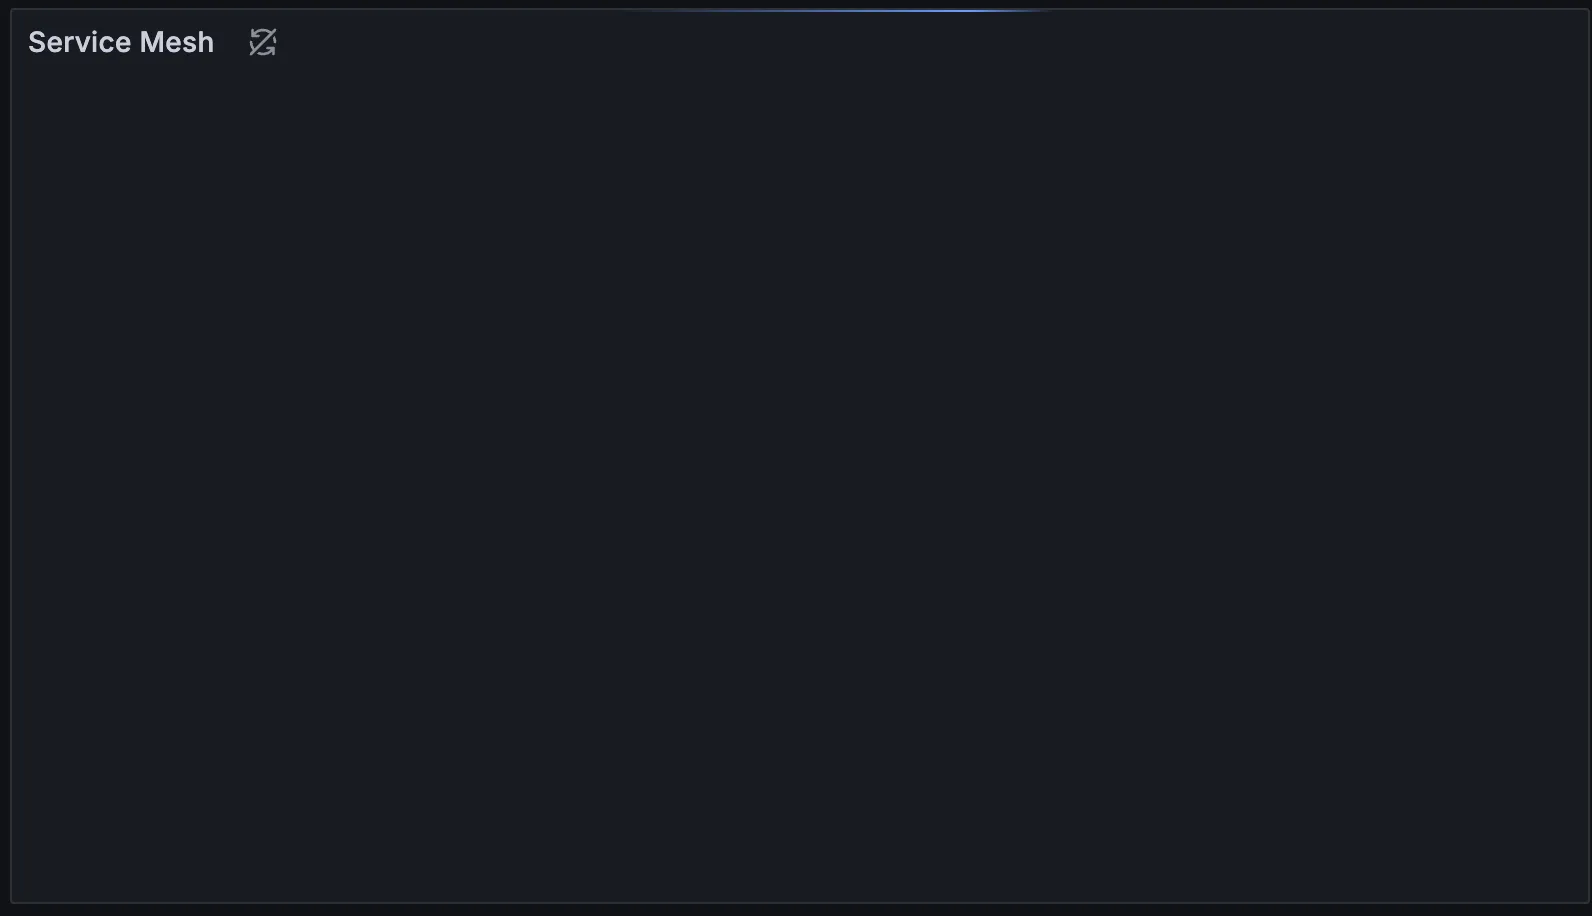 | 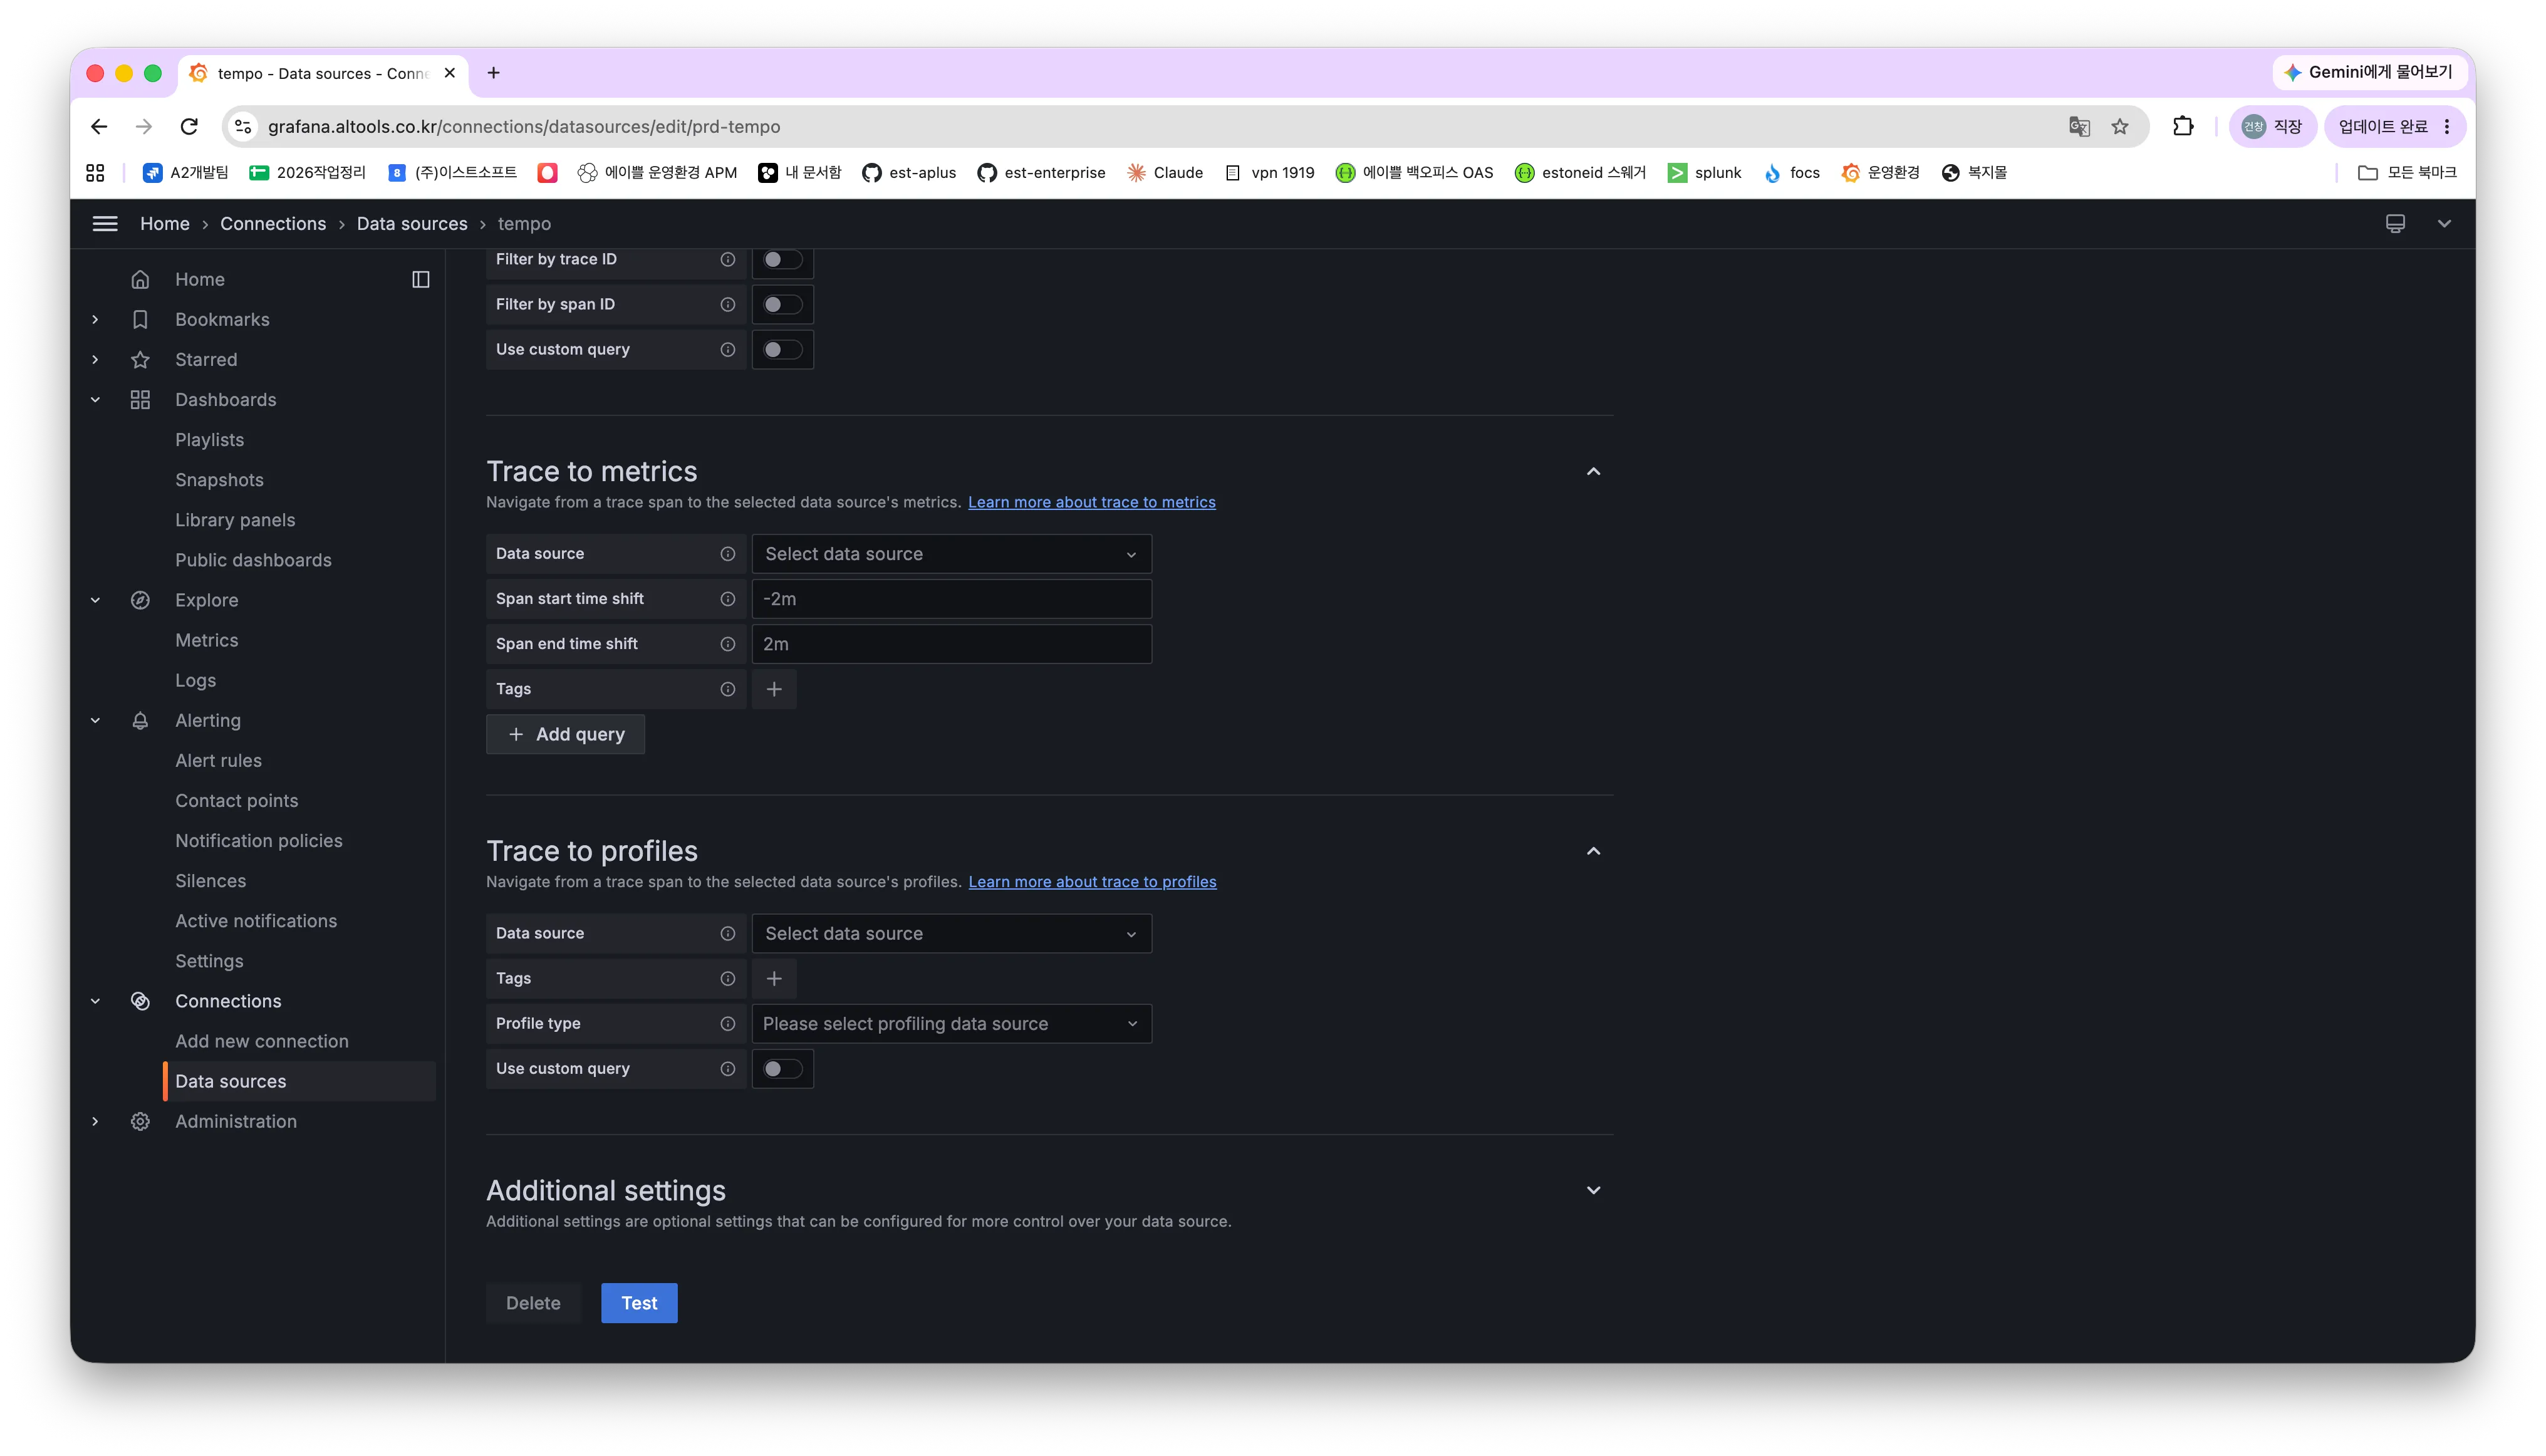 |
원인
인프라팀의 업무가 늘면서 상대적으로 우선순위가 낮은 모니터링 고도화는 진행되지 않았습니다. 개발에 필요한 설정을 직접 수정하고 개선할 관리 방식이 필요했습니다.
해결
개발에 필요한 모니터링 요소를 직접 관리하기
개발에 필요한 모니터링 요소는 개발팀에서 관리하도록 제안했습니다. 제가 datasource 설정과 대시보드, alerts를 Git에서 코드로 관리하고, CI/CD를 통해 변경한 설정이 자동으로 반영되도록 관리 방식을 바꾸기로 했습니다.
Git 기반 배포와 서버 상태 점검 구성하기
test는 개발 환경 검증에, main은 운영 환경 반영을 위한 승격에 사용합니다. 설정을 dev에 자동으로 반영해 검증하고, 정상 동작한 동일 커밋의 설정을 승인 후 prod에 반영하는 구조입니다.
설정 오류를 배포 전에 확인하기
환경별 설정을 구분하고 CI에서 대시보드 설정을 검사해, 잘못된 설정의 반영을 막습니다.
| 구성 | 목적 |
|---|---|
| 환경별 설정 분리 | dev와 prod에 맞는 설정을 구분해 적용 |
| 대시보드 CI 검증 | 배포 전에 대시보드 설정 오류 확인 |
모니터링 서버 자체를 점검하는 watchdog
LGTM 자체의 장애도 감지할 수 있도록, Grafana와 독립적으로 상태를 점검하고 장애와 복구를 기록하는 watchdog을 구성했습니다.
- HTTP 상태와 응답 본문 검사
- 상황: 구성 요소의 상태를 계속 직접 확인하기는 어렵습니다.
- 해결 방법: 1분마다 상태 확인 경로를 호출해 HTTP 상태와 응답 본문을 검사합니다.
- 연속 실패를 기준으로 장애 판정
- 상황: 한 번의 요청 실패만으로는 지속적인 장애인지 알기 어렵습니다.
- 해결 방법: 3회 연속 실패하면 장애로 기록합니다.
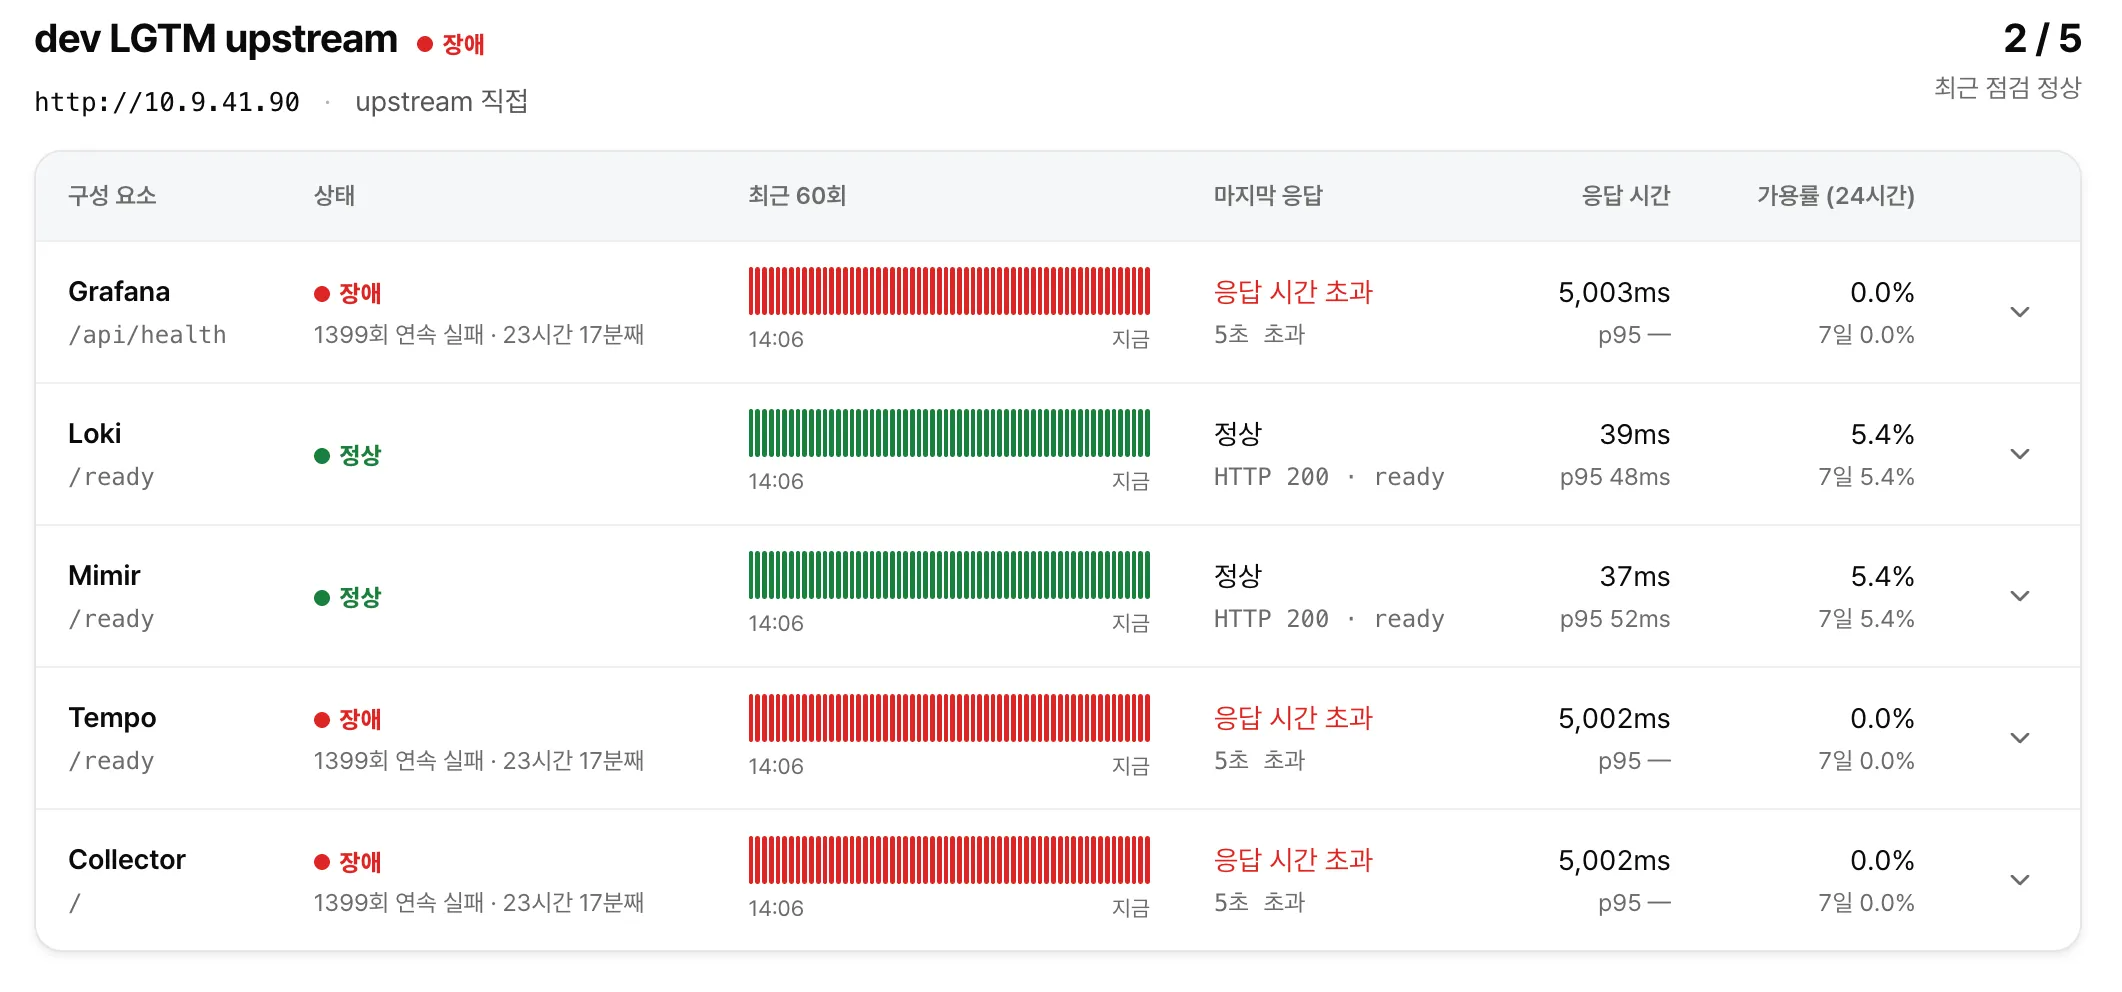
- 연결 경로별 응답 비교
- 상황: 응답 실패가 연결 경로 때문인지 구성 요소 때문인지 구분하기 어렵습니다.
- 해결 방법: Nginx를 거친 요청과 구성 요소에 직접 보낸 요청의 결과를 비교합니다.
- 장애와 복구 이력 보관
- 상황: 현재 상태만으로는 언제 장애가 발생하고 복구됐는지 알 수 없습니다.
- 해결 방법: 장애와 복구 시점, 점검 이력을 함께 보관합니다.
watchdog 구현 일부를 공유합니다.
| Nginx 경유 점검 | upstream 직접 점검 |
|---|---|
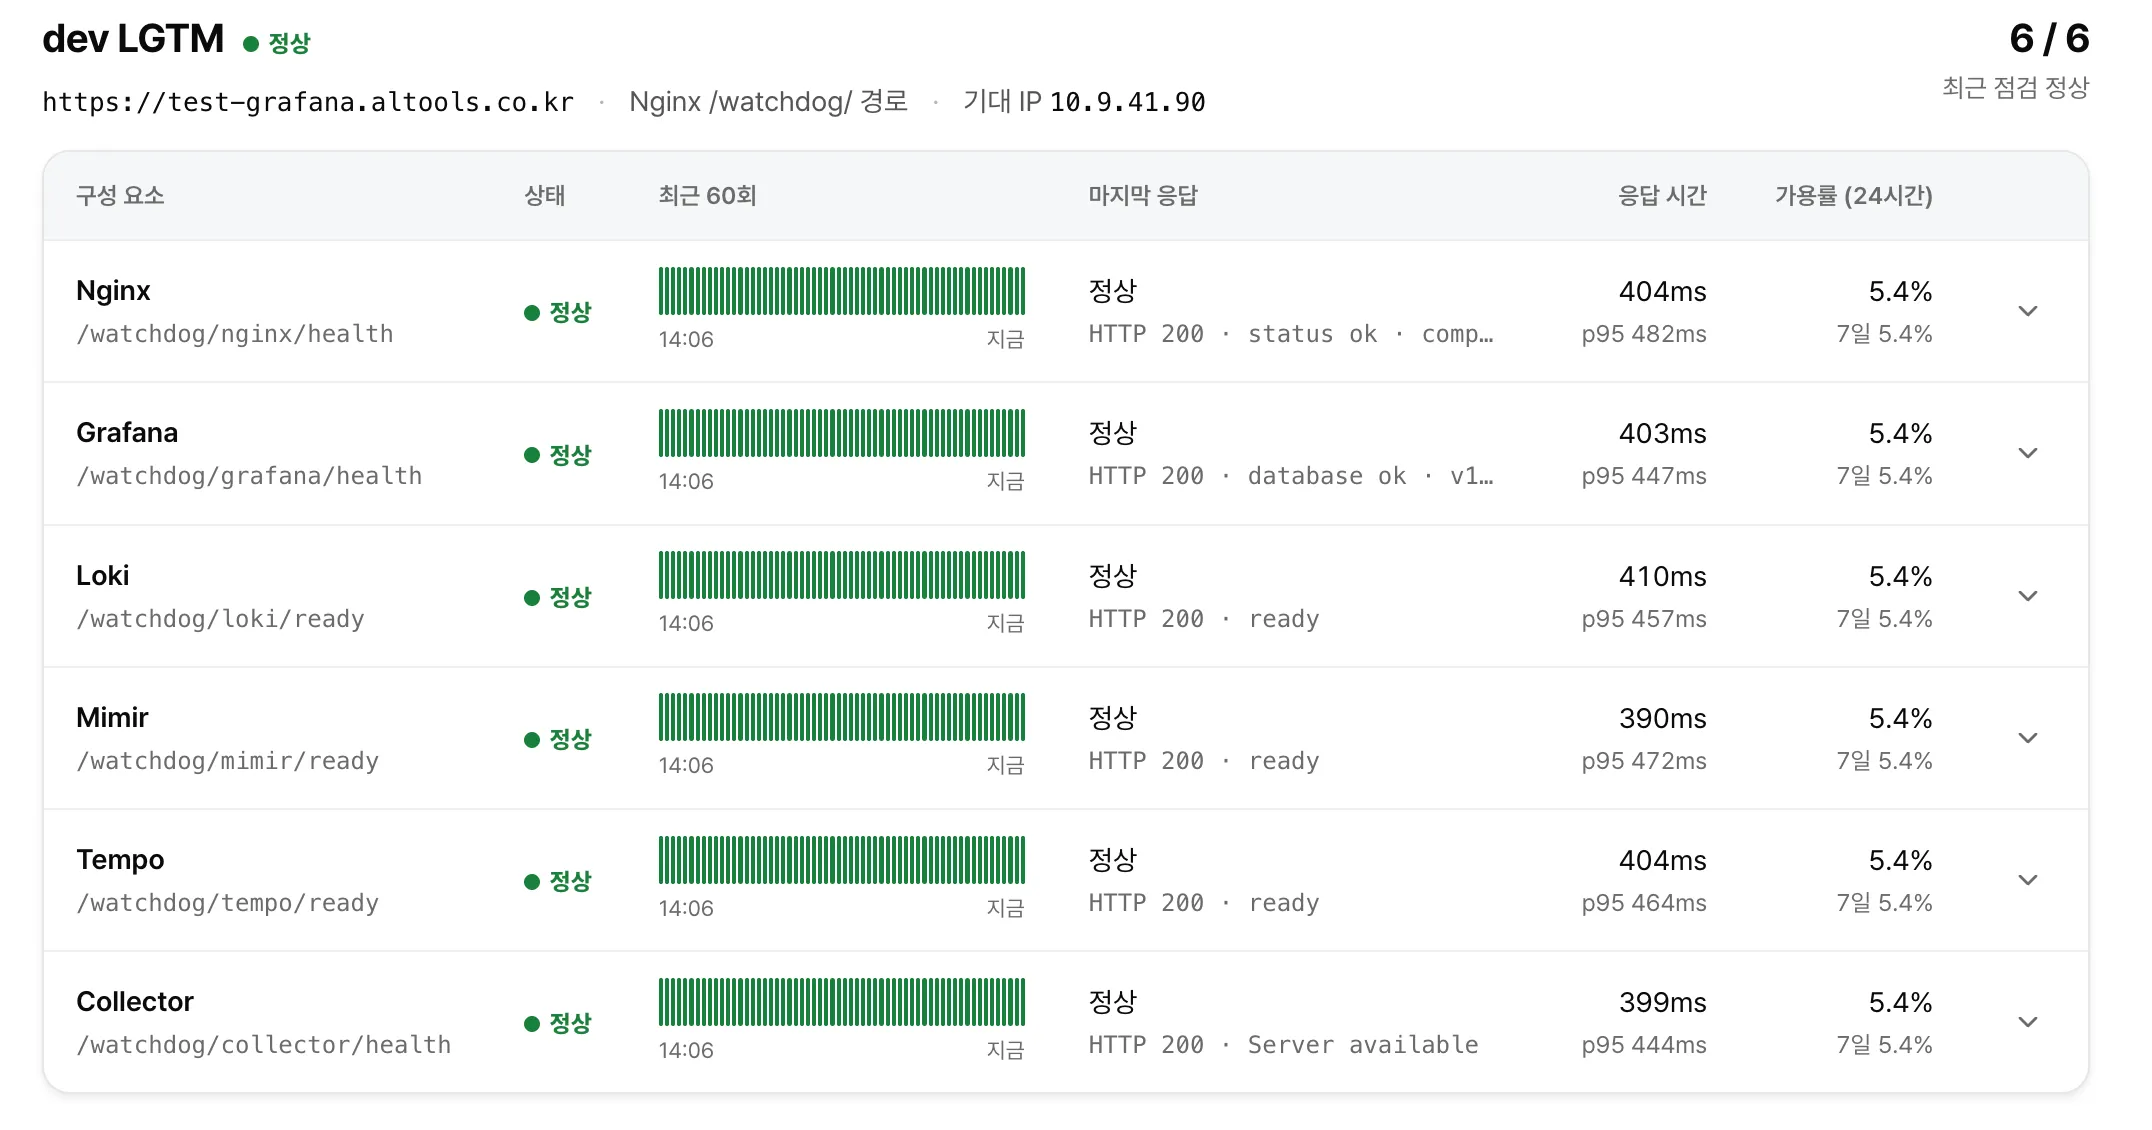 |  |
결과
사내 버셀에 필요한 대시보드와 alerts를 추가하려다, datasource 설정을 직접 바꾸지 못해 개선이 멈추는 문제를 겪었습니다. 이를 계기로 개발에 필요한 모니터링 요소를 개발팀이 관리하도록 제안했고, 제안이 반영되면서 제가 필요한 설정을 직접 관리하기로 했습니다.
설정 변경이 반복돼도 직접 관리할 수 있도록 Git을 기준으로 CI에서 설정을 검사하고, dev에서 검증한 변경을 승인 후 prod에 반영하는 흐름을 설계했습니다. 여기에 watchdog을 구성해 LGTM 자체의 장애와 복구도 확인하도록 했습니다. 설정을 수정하지 못해 막혔던 경험에서 출발해, 개발팀이 변경과 검증, 상태 점검을 함께 맡는 방식으로 풀었습니다.