조회 패턴에 맞춰 복합 인덱스 키 설계하기
복합 인덱스의 컬럼 순서를 정하기 위해 ESR과 ERS의 읽기 및 정렬 비용을 비교했습니다. 조건에 맞는 행 수와 LIMIT에 따라 유리한 순서가 달랐습니다. (ESR/ERS 지침)
| 구성 | 키 순서 | 우선 검토할 상황 | 추가 비용 |
|---|---|---|---|
| ESR | Equality → Sort → Range | 조건에 맞는 최신 몇 건을 빨리 찾을 수 있어 별도 정렬을 줄이려는 경우 | 조건에 맞지 않는 레코드도 읽을 수 있음 |
| ERS | Equality → Range → Sort | 범위 조건에 해당하는 행이 적어 읽을 후보부터 줄이려는 경우 | 범위에 걸친 결과를 추가 정렬해야 할 수 있음 |
여러 쿼리에 활용할 동등 조건(E)의 선두 컬럼 정하기
여러 쿼리에서 재사용할 순서를 찾기 위해 선두 컬럼을 비교했습니다.
- 두 동등 조건을 모두 쓰는 조회: 두 순서 모두 탐색할 수 있습니다.
- 한 조건만 쓰는 조회: 선두 컬럼에 따라 활용 범위가 달라집니다.
| 조회 조건 | 검토할 인덱스 | 활용 방식 |
|---|---|---|
feature_id와 user_id를 모두 동등 조건으로 조회 | 두 컬럼 순서 모두 가능 | 두 조건으로 탐색 범위 지정 |
| 기능별 전체 사용 이력 | (feature_id, user_id) | feature_id만으로 탐색 범위 지정 |
| 사용자별 전체 사용 이력 | (user_id, feature_id) | user_id만으로 탐색 범위 지정 |
- 선두 컬럼을 정할 때: 카디널리티만 보기보다, 함께 처리할 쿼리에서 재사용할 수 있는 순서를 선택합니다.
- 별도 인덱스를 추가할 때: 저장 공간과 쓰기 비용을 더 들일 만큼 다른 순서의 인덱스가 필요한지 확인합니다. (복합 인덱스 사용 방식)
읽는 행 수와 정렬 비용을 비교해 ESR과 ERS 선택하기
SELECT id, user_id, used_at
FROM feature_usage
WHERE feature_id = 'PDF'
  AND user_id BETWEEN 20 AND 40
ORDER BY used_at DESC
LIMIT 2;
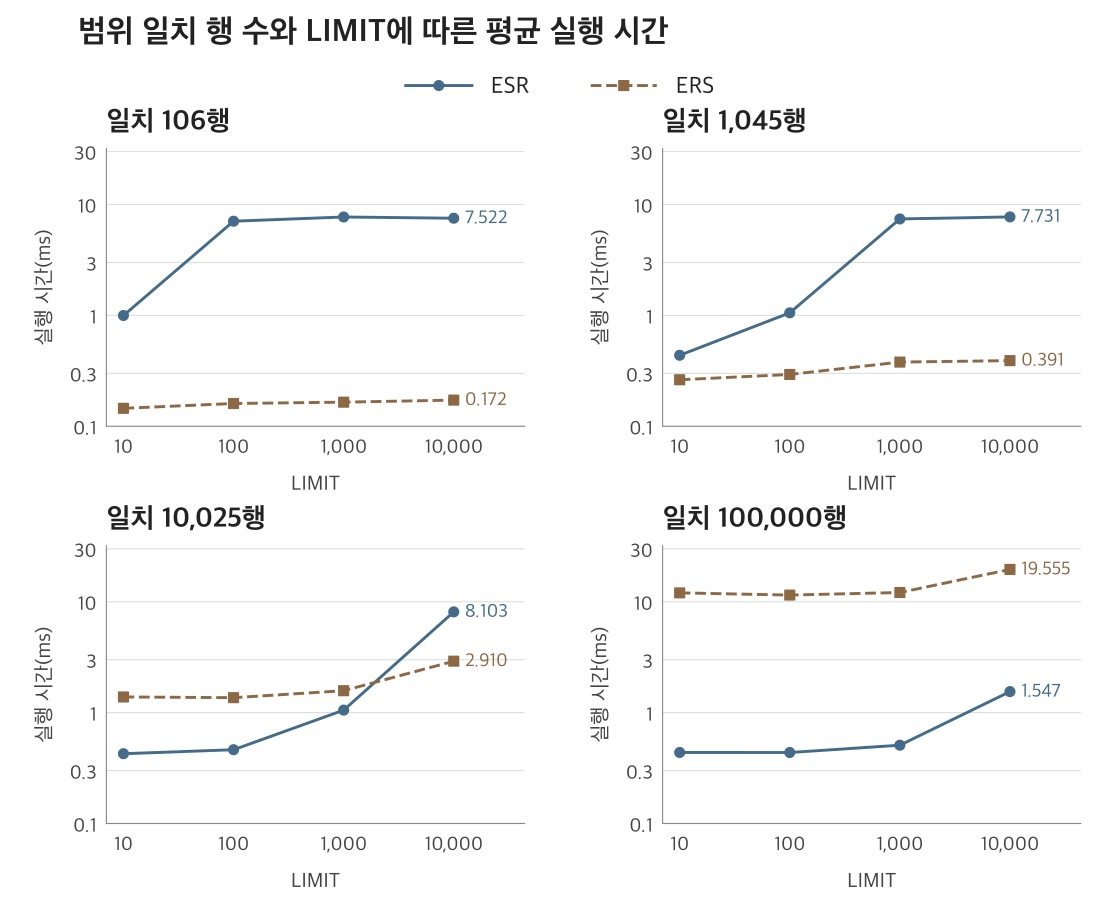
정렬을 우선할지 범위를 먼저 줄일지 판단하기 위해, 한 기능의 10만 행에서 범위 일치 행 수와 LIMIT을 바꿨습니다. 캐시에 적재한 두 Covering Index를 비교한 결과는 다음과 같습니다.
- 일치 행이 적은 조건: ERS가 유리했습니다.
- 범위가 넓고 적은 결과만 찾는 조건: ESR이 유리했습니다.
- 반환량이 늘어나는 조건: ESR의 조기 종료 이점이 줄어 ERS가 유리해지는 경우가 있었습니다.
하나의 LIMIT에서 선택한 순서를 그대로 적용하기보다, 반환량이 늘어나는 조회도 함께 검증해야 합니다. 그래프의 두 축은 로그 눈금입니다.
EXPLAIN ANALYZE로 조기 종료 효과 확인하기
실행 시간 차이의 원인을 확인하려고 인덱스에서 읽은 행 수를 비교했습니다.
- ESR:
LIMIT이 커질수록 탐색량이 늘었습니다. - ERS: 같은 범위에서는
LIMIT이 바뀌어도 읽은 후보 수가 일정했습니다.
| 범위 일치 행 수 | LIMIT | ESR이 읽은 행 수 | ERS가 읽은 행 수 |
|---|---|---|---|
| 10,025 | 10 | 68 | 10,025 |
| 10,025 | 1,000 | 9,897 | 10,025 |
| 10,025 | 10,000 | 99,710 | 10,025 |
| 106 | 1,000 | 100,000 | 106 |
같은 결과를 얻는 두 경로에서도 비용이 발생하는 지점이 다릅니다.
- ESR: 정렬을 피하는 대신 조건에 맞지 않는 레코드도 읽을 수 있습니다.
- ERS: 범위에 맞는 후보를 먼저 줄이는 대신 결과를 추가 정렬합니다.
요청한 수만큼 결과를 빨리 찾기 어렵다면, 정렬 회피보다 ERS로 후보를 먼저 줄이는 구성을 검토해야 합니다.
행 데이터의 추가 조회가 많다면 반환 컬럼까지 포함하기
반환 컬럼을 넣을 때의 추가 비용을 비교하면, 보조 인덱스가 커지고 해당 컬럼을 변경할 때 갱신할 인덱스도 늘어납니다.
| 비교할 작업 | (feature_id, user_id) | (feature_id, user_id, result) |
|---|---|---|
| 보조 인덱스 저장 | 탐색 컬럼과 기본 키 저장 | result를 포함해 인덱스 레코드 크기 증가 |
result 변경 | 이 보조 인덱스의 키는 유지 | Clustered Index와 보조 인덱스 모두 갱신 |
같은 result를 조회하는 경로를 비교하면, Covering Index는 행 데이터의 추가 조회를 줄이는 대신 값을 보조 인덱스에도 저장합니다.
- 자주 읽고 변경이 드문 경우: 추가 조회를 줄이는 Covering Index를 검토합니다.
- 반환할 행이 적거나 값이 길고 자주 바뀌는 경우: 탐색 컬럼만 유지하는 구성과 저장 및 갱신 비용을 우선 비교합니다. (인덱스 유지 비용)
컬럼을 추가하기 전에 실제 값 길이와 페이지 읽기 비교하기
보조 인덱스 페이지는 인덱스를 저장하고 읽는 기본 단위이며, 이번 비교의 페이지 크기는 16KiB입니다. 키 값 길이에 따른 조회 구조를 비교하면, 같은 행을 조회해도 필요한 페이지와 캐시 공간은 달라질 수 있습니다. 선언 길이만 줄이기보다 실제 값 길이와 자주 읽는 범위를 기준으로 포함할 컬럼을 정해야 합니다. (문자열 타입, InnoDB 페이지 구조)
같은 100만 행에서 실제 키 값 길이에 따른 인덱스 용량을 비교했습니다. 컬럼 선언을 VARBINARY(256)으로 유지해도, 저장한 값이 길어질수록 페이지 수와 용량이 늘었습니다.
| 실제 키 값 길이 | 보조 인덱스 페이지 수 | 용량 |
|---|---|---|
| 16바이트 | 2,342 | 36.59MiB |
| 64바이트 | 5,755 | 89.92MiB |
| 256바이트 | 19,776 | 309.00MiB |
Buffer Pool 64MiB에서 캐시 초기화 후 첫 조회와 같은 64개 쿼리를 반복한 경우를 비교했습니다. 초기 5회와 반복 15회의 산술평균에서, 가장 긴 키 값 조건은 반복 조회에서도 매번 추가 읽기가 남았습니다.
| 키 값 길이 | 초기 평균(ms) | 반복 평균(ms) | 초기 평균 읽기(MiB) | 반복 평균 읽기(MiB) | 반복 읽기 발생 |
|---|---|---|---|---|---|
| 16바이트 | 92.30 | 59.12 | 16.69 | 0.00 | 0/15회 |
| 64바이트 | 151.67 | 62.28 | 40.28 | 1.05 | 5/15회 |
| 256바이트 | 369.29 | 315.72 | 138.97 | 105.67 | 15/15회 |
반복 조회의 추가 읽기를 줄이기 위해 메모리와 저장소 접근을 비교했습니다. 같은 쿼리라도 필요한 페이지가 캐시에 남지 않으면 저장소 읽기가 반복됩니다.
- 증설 여부를 판단할 때: 전체 인덱스 용량보다 반복 조회의 추가 읽기를 기준으로 봅니다.
- 추가 읽기가 계속 남을 때: 불필요한 컬럼 제거와 Buffer Pool 확대를 비교합니다.
- Buffer Pool을 늘릴 때: 연결과 정렬 등 다른 작업에 필요한 메모리도 남깁니다. (Buffer Pool)
대표 쿼리의 실행 계획으로 인덱스 후보 검증하기
같은 쿼리도 조건값에 따라 읽는 양이 달라지므로, 다음 항목을 확인한 뒤 최종 구성을 정합니다.
- 조회 조건: 자주 조회하는 값과 일치 행이 많은 값을 모두 확인합니다.
- 실행 계획:
EXPLAIN ANALYZE의 읽은 행 수, 실행 시간과 정렬 여부를 비교합니다. (실행 계획 확인)