샤딩은 하나의 데이터 집합을 여러 DB에 나누어 저장하고 처리하는 방식이다. 예를 들어 주문 테이블의 행을 사용자 ID 기준으로 나누고, 사용자별로 정해진 DB에 저장한다. 나뉜 데이터 단위를 샤드, 배치를 결정하는 기준 값을 샤드 키라고 한다.
주문을 DB 1과 DB 2에 나누어 저장한 모습이다. 테이블 구조는 같고 저장된 행이 다르다. C는 두 DB에 나뉘어 있는 이동 대상 주문을 표시한다.
이렇게 저장량과 요청을 여러 DB 서버에 분산할 수 있다. 다만 사용자 기준으로 나누면 주문 처리는 한 DB에서 끝낼 수 있어도, 판매자별 목록과 전체 매출 집계는 여러 DB에 걸친다. 데이터가 늘거나 특정 사용자에게 요청이 집중되면 배치도 다시 바꿔야 한다.
사용자별 주문 처리를 한 DB에서 끝내기 위한 데이터 배치와 조회 조건 정하기
사용자별 주문 처리가 주된 작업이라면 사용자 ID(tenant_id)를 샤드 키로 삼고 주문과 주문 항목을 같은 샤드에 둔다. 관련 조회와 변경을 한 DB에서 끝내기 위한 선택이다.
- 다른 DB에 저장: 주문과 항목을 각각 조회하고, 결과를 앱에서 합친다.
- 같은 DB에 저장: JOIN 쿼리로 주문과 항목을 함께 가져온다.
| 접근 방식 | 사용자 ID 기준 배치에서 필요한 작업 |
|---|---|
| 사용자 ID와 주문 ID로 주문 조회 | 사용자에 해당하는 샤드에서 조회 |
| 주문 ID만으로 조회 | 대상 샤드를 알아낼 추가 정보가 없으면 여러 샤드 조회 |
| 판매자별 주문 목록 | 여러 샤드 조회 또는 판매자 기준 조회 구조 필요 |
| 전체 판매자의 매출 집계 | 여러 샤드의 집계 결과 병합 또는 분석용 저장소 필요 |
Notion도 워크스페이스 ID로 블록과 관련 테이블을 함께 나눠 주요 요청을 같은 샤드에서 처리하도록 설계했다. Notion의 샤딩 설계
조회 조건에도 샤드 키를 전달해야 한다. 주문 ID만으로 대상 샤드를 알 수 없다면 여러 샤드에 조회해야 한다.
- 데이터 배치: 한 호스트의 MySQL 네 프로세스에 합성 주문 200만 건을
tenant_id % 4로 분산했다. - 조회 방식: 샤드 키로 단일 DB를 조회하는 경우와 scatter-gather를 비교했다. scatter-gather는 여러 샤드에 쿼리를 보내고 결과를 모으는 방식이다.
- 측정 방법: 연결을 예열한 뒤 200쌍을 번갈아 측정했다. 요청 분배부터 결과 수신과 병합까지 포함했다.
| 방식 | 요청당 DB 쿼리 수 | 중앙값 | p95 |
|---|---|---|---|
| 샤드 키로 단일 DB 조회 | 1 | 0.3ms | 0.9ms |
| 전체 샤드 병렬 조회 | 4 | 0.5ms | 1.4ms |
샤드 키가 없으면 네 DB에서 각각 기본 키 인덱스를 조회한다. 한 행을 찾는 데 필요한 DB 쿼리가 네 번으로 늘었다.
Vitess의 Vindex는 키로 대상 샤드를 찾는 규칙이다. tenant_id에 hash Vindex를 적용하고 주문과 주문 항목을 함께 배치했다. vttestserver의 MySQL 한 개에 네 논리 샤드를 구성하고 VEXPLAIN QUERIES로 실행 경로를 확인했다. Vindex, VEXPLAIN
VEXPLAIN QUERIES
SELECT id, tenant_id, seller_id, amount_cents
FROM orders
WHERE tenant_id = 1 AND id = 101;| 쿼리 조건과 작업 | 실제 실행 샤드 수 | 확인한 동작 |
|---|---|---|
tenant_id = 1 AND id = 101 | 1 | EqualUnique 계획으로 -40 샤드 조회 |
id = 101 | 4 | Scatter 계획으로 전체 샤드 조회, 같은 주문 반환 |
판매자별 COUNT, SUM | 4 | 샤드별 부분 집계 후 VTGate에서 병합 |
| 사용자 ID를 포함한 주문과 주문 항목 JOIN | 1 | 같은 샤드에서 JOIN 실행 |
프록시가 SQL을 분배해도 키 없이 조회하는 비용은 남는다. Shopify도 Vitess 도입 전에 사용자 소유 테이블에 user_id를 추가하고 샤드 키가 빠진 쿼리를 검출했다. Shopify의 Vitess 전환
샤딩을 구현하는 세 가지 방법 비교하기
JPA 표준은 자동 샤딩을 제공하지 않는다. 직접 구현할 때는 Spring의 AbstractRoutingDataSource로 연결을 선택하고, JDBC 라이브러리나 DB 프록시를 사용할 때는 해당 계층에 SQL 라우팅을 맡긴다.
| 방식 | JPA에서 DB까지의 경로 | 선택할 상황 | 추가 비용 |
|---|---|---|---|
| 애플리케이션 직접 구현 | JPA → 라우팅 DataSource → 샤드 DB | 대상 샤드를 명확히 선택할 수 있고 라우팅을 직접 통제할 때 | 매핑, 샤드 간 조회와 운영 도구를 직접 관리 |
| JDBC 라이브러리 | JPA → ShardingSphere-JDBC → 샤드 DB | Java 안에서 SQL 라우팅과 결과 병합을 위임할 때 | 지원 SQL 검증, 애플리케이션별 라이브러리와 설정 관리 |
| DB 프록시 | JPA → JDBC → Vitess 또는 ShardingSphere-Proxy → 샤드 DB | 여러 언어와 애플리케이션에 공통 접속점을 제공할 때 | 프록시 배포, 가용성 관리와 추가 네트워크 경로 |
직접 구현에서는 트랜잭션 전에 샤드를 결정하고 끝날 때까지 유지한다. AbstractRoutingDataSource는 getConnection() 시점에 키를 확인한다. 키가 없거나 등록되지 않았으면 연결을 거부하도록 구성한다. Spring 라우팅 API
class Routing extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        String shard = SHARD.get();
        if (shard == null) {
            throw new IllegalStateException("Missing shard");
        }
        return shard;
    }
}

routing.setTargetDataSources(Map.of("A", databaseA, "B", databaseB));
routing.setLenientFallback(false);
routing.afterPropertiesSet();
기존 트랜잭션과 영속성 컨텍스트가 없는 진입점에서 키를 설정한다. 필요한 값을 트랜잭션 안에서 읽고 종료 후 키를 정리한다.
SHARD.set("B");
try {
    return tx.execute(status ->
        orders.findById(1L).orElseThrow().getMarker()
    );
} finally {
    SHARD.remove();
}
같은 ID 1에 값만 A, B로 다르게 저장한 두 H2 DB를 Spring Data JPA로 조회했다. OSIV와 2차 캐시는 껐다.
| 실행 조건 | 읽은 값 |
|---|---|
| 샤드 A를 선택하고 트랜잭션에서 조회 | A |
| 같은 트랜잭션에서 키를 B로 바꾼 뒤 재조회 | A |
EntityManager.clear() 후 재조회 | A |
| 같은 트랜잭션에서 native SQL로 조회 | A |
| 트랜잭션 종료 후 B를 선택하고 새 트랜잭션에서 조회 | B |
연결을 확보한 뒤에는 라우팅 키를 바꿔도 같은 연결을 사용한다. 샤드를 바꾸려면 트랜잭션을 끝내고 새로 시작해야 한다.
ShardingSphere-JDBC에서는 sharding.yaml의 샤딩 규칙을 읽는 DataSource에 JPA를 연결한다. ShardingSphere-JDBC 설정
spring.datasource.driver-class-name=org.apache.shardingsphere.driver.ShardingSphereDriver
spring.datasource.url=jdbc:shardingsphere:classpath:sharding.yaml
프록시 방식에서는 일반 JDBC 드라이버로 Vitess나 ShardingSphere-Proxy에 접속한다. VTGate를 가리키는 DataSource에 JPA Repository를 연결했다.
public interface Orders extends JpaRepository<VitessOrder, Long> {
    Optional<VitessOrder> findByTenantIdAndId(Long tenantId, Long id);
}
생성 SQL을 같은 바인딩 값으로 VEXPLAIN에서 실행했을 때 findByTenantIdAndId는 한 샤드, findById와 count()는 네 샤드에서 실행됐다. 연결 경로를 바꿔도 단일 샤드로 제한할 요청에는 샤드 키를 전달해야 한다.
여러 DB의 반복 조회를 줄이기 위한 조회용 데이터 만들기
사용자별 주문 원천은 유지하고, 반복되는 목록과 분석 요청은 별도로 준비한 데이터에서 처리할 수 있다. OLAP에서도 분산 실행은 가능하다. 다만 OLTP의 사용자별 배치가 분석 조건에 맞지 않으면 여러 샤드를 읽고 결과를 병합해야 한다.
| 필요한 조회 | 추가할 구조 | 유지 비용 |
|---|---|---|
| 주문 ID만으로 상세 조회 | 주문 ID에서 샤드를 찾는 매핑 또는 전역 인덱스 | 원천과 매핑의 일관성과 가용성 |
| 반복되는 주문 상세 조회 | 원천 앞의 결과 캐시 | 무효화, 만료와 캐시 미스 시 부하 |
| 판매자별 주문 목록 | 판매자 기준 조회 모델 | 변경 전달, 갱신 지연과 페이징 |
| 날짜와 판매자별 매출 분석 | OLAP 저장소와 목적별 데이터마트 | 적재와 집계, 변경과 삭제 반영 |
Vitess의 Lookup Vindex도 다른 키로 대상 샤드를 찾는 전역 인덱스다. 조회 범위를 줄이는 대신 매핑을 유지하는 쓰기가 추가된다. Lookup Vindex
반복 집계는 변경 이벤트나 CDC를 분석용 저장소로 전달해 미리 계산할 수 있다. 주문 200만 건의 판매자별 주문 수와 금액 합계를 네 MySQL DB에서 부분 집계한 뒤 병합하는 방식과, 샤드 0에 저장한 200행의 집계 테이블을 읽는 방식을 비교했다. 원천을 고정하고 예열 후 30쌍을 번갈아 측정했다.
| 방식 | 읽는 행 수 | 중앙값 | p95 |
|---|---|---|---|
| 네 샤드의 부분 집계 후 병합 | 원천 총 2,000,000행 | 71.6ms | 75.5ms |
| 사전 집계 테이블 조회 | 집계 200행 | 0.8ms | 1.5ms |
- 초기 집계 작성: 82.2ms가 걸렸다.
- 원천 변경 후 갱신 전 조회: 주문 금액이 바뀌어도 집계 테이블은 이전 값을 반환했다.
- 전체 갱신: 76.6ms가 걸렸다. 조회와 집계 실행 계획 및 결과
DB 한 대의 저장량과 요청량을 줄이기 위한 데이터 재배치하기
접근 경로를 분리해도 원천의 저장량이나 요청량이 한 DB의 한계를 넘으면 배치를 바꿔야 한다.
- 전체 데이터가 늘어날 때: 샤드를 추가해 데이터를 나눌 수 있다.
- 특정 키에 요청이 집중될 때: 핫키의 데이터와 요청을 전용 샤드로 분리해 다른 사용자의 부하와 나눌 수 있다.
논리 버킷이나 특정 사용자처럼 옮길 단위를 정하고, 선택한 묶음만 새 DB로 보낸다. DB 1과 DB 2에 나뉜 C 주문을 새 DB 3에 모은다. C는 서로 다른 샤드 키의 주문 묶음이다.
- 데이터 이동: DB 1과 DB 2의 C 데이터를 DB 3으로 옮기고, 그동안 발생한 추가와 수정, 삭제까지 반영해 일치하는지 확인한다.
- 주문 분기 변경: C의 쓰기를 잠시 대기시키고 마지막 변경분까지 반영한 뒤, C 주문 요청을 DB 3으로 보낸다. A와 B의 경로는 유지한다.
실선은 기존 주문 요청 경로, 점선은 추가되는 데이터 이동과 C 주문 요청 경로다.
물리 DB 수를 그대로 hash(key) % N에 넣으면 DB 수를 바꿀 때 많은 키의 목적지가 달라진다. 키 10만 개를 SHA-256으로 해시해 네 DB에서 다섯 DB로 늘리는 계산을 비교했다. 고정 버킷 방식은 100개 중 기존 DB마다 5개씩 총 20개를 새 DB로 옮겼다.
| 배치 방식 | 위치가 바뀐 키 | 전체 키 대비 |
|---|---|---|
hash(key) % 4에서 % 5로 변경 | 79,650개 | 79.7% |
| 고정 논리 버킷 100개 중 20개 이동 | 19,977개 | 20.0% |
논리 샤드를 고정하면 옮길 버킷을 선택할 수 있고, 버킷과 DB의 매핑을 갱신해 경로를 바꾼다.
특정 사용자에 집중된 요청을 분리하기 위한 핫키 라우팅 구성하기
요청이 집중되는 샤드 키를 핫키라고 한다. 사용자 42의 주문 요청이 DB 1에 몰리면 같은 DB를 사용하는 A의 요청도 커넥션이나 쿼리 처리를 기다릴 수 있다. 데이터 건수가 고르게 나뉘어 있어도 요청량은 한 DB에 집중될 수 있다.
42의 데이터와 요청을 DB 3으로 분리하면 A와 다른 DB에서 처리할 수 있다. 점선은 새로 추가하는 DB와 라우팅 경로다.
42의 데이터를 옮긴 뒤 일반 키의 라우팅 규칙보다 먼저 전용 샤드를 선택하도록 구성한다.
직접 구현에서는 핫키와 대상 샤드를 정책 저장소에서 관리하고, 변경된 정책을 받으면 불변 맵을 교체한다. 샤드는 트랜잭션 전에 선택한다.
AtomicReference<Map<Long, String>> hotKeyShards =
    new AtomicReference<>(Map.of());

String shardFor(long tenantId) {
    return hotKeyShards.get().getOrDefault(
        tenantId, "ds_" + Math.floorMod(tenantId, 4)
    );
}

void applyHotKeyPolicy(Map<Long, String> nextPolicy) {
    hotKeyShards.set(Map.copyOf(nextPolicy));
}TenantRouter.java
ShardingSphere-JDBC와 Proxy에서는 샤딩 알고리즘에서 핫키의 목적지를 먼저 선택한다. ds_hot을 DataSource와 실제 데이터 노드에 추가하고 주문과 주문 항목의 tenant_id 분산 규칙에 연결한다. ShardingSphere 알고리즘
shardingAlgorithms:
  tenant_route:
    type: INLINE
    props:
      algorithm-expression: "ds_${tenant_id == 42 ? 'hot' : tenant_id % 4}"sharding.yaml
Vitess는 numeric_static_map으로 명시적 매핑과 기본 해시를 조합할 수 있다. 다음 Vindex를 주문과 주문 항목의 tenant_id에 연결하면 42는 keyspace ID 1로, 나머지는 해시로 매핑된다.
{
  "tenant_route": {
    "type": "numeric_static_map",
    "params": {
      "json": "{\"42\":1}",
      "fallback_type": "hash"
    }
  }
}vschema.json
일반 키도 같은 샤드에 도착할 수 있으므로 전용 샤드로 격리하려면 keyrange 배치까지 설계해야 한다. Vitess Vindex
운영 중 42의 경로를 교체하는 예
ds_hot의 연결과 테이블을 준비한 뒤 42의 경로를 ds_2 → ds_hot으로 바꾼다. 요청 재개 전에는 마지막 변경분을 반영하고 모든 앱이 ds_hot으로 라우팅하는지 확인한다. 실선은 요청 경로, 점선은 데이터 복제다.
applyHotKeyPolicy(Map.of(42L, "ds_hot"));| 방식 | 운영 중 교체하는 위치 |
|---|---|
| 직접 구현 | 각 애플리케이션에서 새 정책으로 applyHotKeyPolicy 호출 |
| ShardingSphere-JDBC | 로컬 YAML 구성은 변경한 설정으로 DataSource를 다시 구성해 배포. Cluster 모드는 공유 메타데이터 변경을 전파 |
| ShardingSphere-Proxy | DistSQL ALTER SHARDING TABLE RULE로 주문과 주문 항목의 라우팅 규칙 변경 |
| Vitess | 변경한 numeric_static_map을 포함한 전체 VSchema를 ApplyVSchema로 적용. 바뀐 keyspace ID에 맞는 데이터 이관은 별도로 구성 |
복사 중 추가되거나 수정된 데이터까지 반영한 뒤 DB 전환하기
복사 중 발생한 추가와 수정, 삭제까지 반영한 뒤 요청 경로를 전환한다.
| 방식 | 데이터 이동 | 전환과 중단 판단 | 한계와 주의 사항 |
|---|---|---|---|
| 직접 구현 | 전체 복사 후 CDC 또는 원본과 대상에 dual write | 기존 쓰기 중지 후 새 정책 적용 | 한쪽 쓰기만 성공할 때의 재시도와 정합성 처리를 직접 구현 |
| ShardingSphere-JDBC | 외부 도구로 데이터 이관 | 앱 요청 제어 후 샤딩 규칙 변경 | 데이터 이동과 앱 인스턴스별 설정 반영을 별도로 관리 |
| ShardingSphere-Proxy migration (5.5.3) | 새 대상 클러스터로 전체 복사와 증분 반영 | read-only 구간이 필요할 수 있으며 트래픽 전환은 운영자가 제어 | 복사 속도와 병렬도를 낮추면 원본 부하는 줄고 이관 시간은 증가 |
| Vitess Reshard | VReplication으로 복사와 증분 반영, VDiff 검증 | SwitchTraffic에서 쓰기 일시 중지, VTGate 버퍼링으로 요청 대기 | 기존 Vindex 유지, 버퍼 용량과 timeout 제약 |
재샤딩 중 요청 지연과 오류 측정을 위해 실험하기
버퍼링은 전환 중 요청을 대기시켰다가 새 샤드로 보내는 기능이다. Reshard, VTGate 버퍼링
- DB와 데이터: 소스 MySQL 한 개에서 대상 두 개로 주문 30만 행을 옮겼다.
- 환경: 한 호스트에서 Vitess 24.0.2 에뮬레이션으로 최대 동시 요청 4개를 처리했다.
- 요청: 같은 VTGate 연결로 읽기와 쓰기를 계속 보냈다. 클라이언트 재시도 없이 각 쓰기 방식을 한 번씩 실행했다.
- 버퍼링: 요청별 대기 한도를 10초로 설정했다.
아래는 명시적 트랜잭션 실행의 성공 요청 p95다.
- 쓰기 시간:
BEGIN → INSERT → COMMIT전체를 측정했다. - 전환 구간: SwitchTraffic 실행 시간과 겹친 요청을 포함했다.
가로축은 구간 순서다. 위 그래프는 전체 구간을, 아래 그래프는 약 2s의 전환 구간을 제외한 나머지 네 구간을 연결해 보여준다.
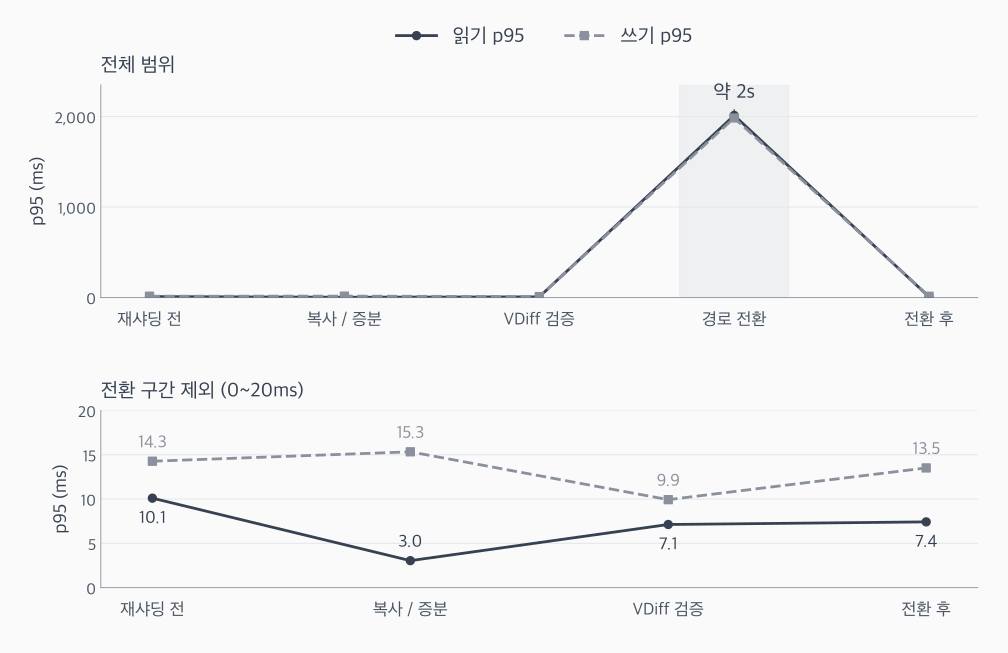
전환 중 요청 4건이 버퍼에 들어갔다가 다시 처리됐고 약 2초까지 기다렸다. 아래 최대 지연에는 오류 응답까지 포함한다.
| 쓰기 방식 | 전환 읽기 최대 | 전환 쓰기 최대 | 쓰기 오류 |
|---|---|---|---|
| autocommit INSERT | 2,049.5ms | 2,036.9ms | 2 |
| BEGIN → INSERT → COMMIT | 2,013.2ms | 1,985.3ms | 0 |
autocommit INSERT에서는 버퍼 해제 직후 VT13001: [BUG] unexpected 'autocommitted' state in transaction 오류가 발생했다. autocommitted는 SQL을 보내기 전에 설정하는 VTGate의 내부 최적화 상태다. 이 상태가 재시도에도 남아 새 트랜잭션 ID를 등록할 때 충돌한다.
명시적 트랜잭션은 처음부터 일반 트랜잭션 경로를 사용해 이 autocommit 최적화를 건너뛴다. VTGate 재시도, autocommit 상태 검사, 트랜잭션 실행