조회할 데이터를 줄이기 위한 일 집계와 월 집계 비교하기
Rill 대시보드에서 1년치 전체 기기 수와 앱별 통계를 조회할 때 ClickHouse CPU 사용률이 높아졌습니다. 집계 테이블을 사용해도 1년치 데이터를 읽고 병합하는 연산은 필요했습니다. 여러 사용자가 같은 화면을 열면 같은 집계도 반복 실행됐습니다.
원인을 찾기 위해 두 항목을 확인했습니다.
- 조회 한 번에 읽고 병합하는 데이터량
- 같은 조건의 동시 요청이 실행하는 집계 횟수
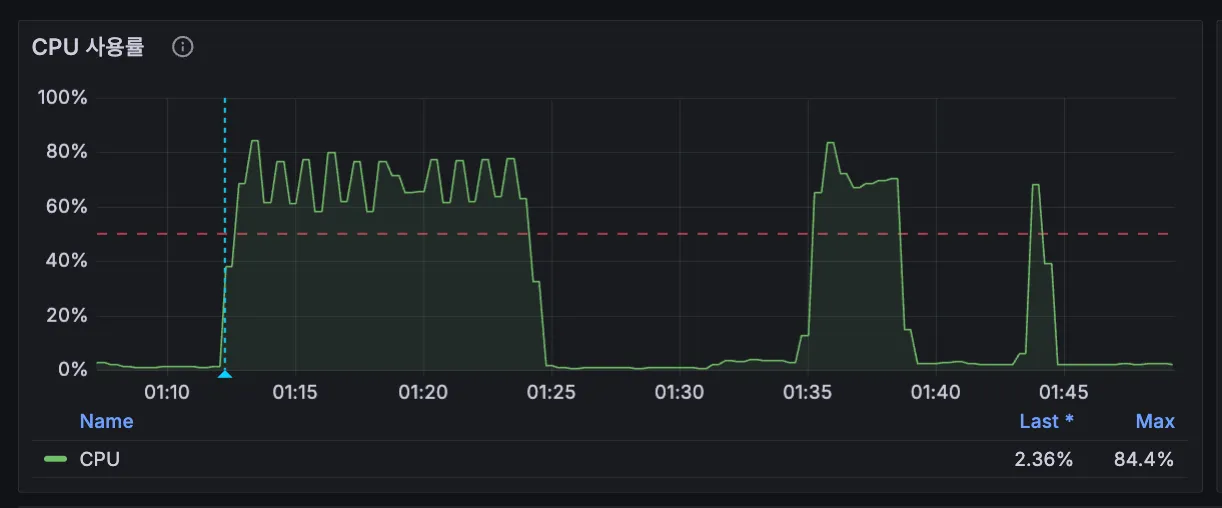
- CPU 사용률 최댓값: 84.4%
일 집계는 날짜와 앱, 버전, OS 등의 조합마다 한 행을 저장했습니다. 월별 통계를 계산하려면 조회 기간의 조합별 집계를 모두 읽고 병합해야 했습니다.
운영 ClickHouse에서 일 집계와 월 집계를 비교했습니다.
- 조회 범위: 같은 13개월
- 실행 조건: 쿼리당 2스레드, 캐시 OFF
월 집계로 조회하자 읽는 행 수가 319만에서 44.5만으로 줄었습니다.
| 패널 | 일 집계 조회 시간 | 월 집계 조회 시간 | 속도 비율 |
|---|---|---|---|
| 전체 이벤트 수와 기기 수 카드 | 11.93s | 2.82s | 4.2배 |
| 앱별 기기당 실행 횟수 | 11.60s | 2.49s | 4.7배 |
| OS 세부 버전 | 13.10s | 3.13s | 4.2배 |
초기 측정에서도 읽은 양은 295MiB에서 40MiB로 줄었습니다.
필요한 차원만 남기는 방법도 비교했습니다
OS별 통계를 구할 때도 앱 버전과 서버별로 나뉜 집계 상태를 모두 병합했습니다. 조회에 쓰지 않는 차원을 집계 기준에서 제외하면 병합할 데이터량이 줄어드는지 비교했습니다. 아래는 상품별 판매량을 구할 때 판매 경로와 지역 구분을 제외한 예시입니다.
운영 데이터로 1년치 기기 수를 조회했습니다. 모든 집계는 쿼리당 2스레드, 캐시 OFF 조건에서 비교했습니다.
| 집계 방식 | 읽는 행 수 | 조회 시간 | 저장 공간 |
|---|---|---|---|
| 기존 일 집계 | 315만 | 11.4 ~ 18.4s | 4.56GiB |
| 월 집계 | 44.5만 | 2.5 ~ 4.2s | 1.03GiB |
| 통합 집계 | 43.7만 | 7 ~ 11.3s | 2.76GiB 추가 |
| 앱별 집계 | 3.5만 | 5.9 ~ 8s | 1.02GiB 추가 |
| OS별 집계 | 5.1만 | 5.4s | 0.92GiB 추가 |
앱별 집계의 행 수는 기존 일 집계의 1/91이었지만, 기기 집계 데이터량은 1/4.5였습니다. 행 수만큼 병합할 데이터량이 줄지는 않았습니다. 추가한 세 집계 모두 월 집계보다 느리고 저장 공간도 늘어 비교 후 삭제했습니다.
읽는 데이터량을 줄이기 위한 집계 형식 비교하기
별도의 합성 데이터로 1년치 KPI를 조회해, 기기 집계 상태의 저장 형식별로 읽은 데이터량을 비교했습니다.
| 집계 형식 | 읽은 데이터량 |
|---|---|
기존 uniqState | 13MiB |
| HLL12 | 23MiB |
| 비트맵 | 26MiB |
기존 구조는 기기 UUID 목록 대신 uniqState로 만든 요약 상태를 저장했습니다.
AggregatingMergeTree: 같은 집계 기준의 상태를 병합uniqState(uuid): UUID의 요약 상태를 저장uniqMerge: 조회 기간의 상태를 병합해 기기 수 계산
이번 비교에서는 기존 uniqState가 읽은 데이터량이 가장 적었습니다. 집계 상태 병합, uniq 동작
프로젝션은 직접 조회와 Rill 뷰 조회를 나눠 비교했습니다.
- 직접 조회: 읽는 행 수가 1/10로 감소
- Rill 뷰 조회: 프로젝션을 사용하지 않음
조회 시간이 가장 짧았던 기존 월 집계를 유지했습니다. Rill의 월 롤업 조건에 맞춰 조회 시작일과 종료일을 월 1일로 맞추고, 조회 단위를 월로 설정했습니다.
- 기간 선택: 이번 달과 지난 3개월, 6개월, 12개월
- 달력 선택: 비활성화
- 개요의 일별 그래프: 일 집계 유지
Rill에서 전체 기간(All time) 선택은 제거할 수 없었습니다. 이 조회는 일 집계를 사용해 11 ~ 18s가 걸렸습니다.
같은 집계를 반복 실행하지 않기 위한 캐시와 singleflight 비교하기
월 집계로 조회 한 번에 읽는 데이터량은 줄였지만, 여러 사용자가 같은 대시보드를 열면 같은 기간과 조건의 요청이 동시에 들어왔습니다. 첫 요청의 결과를 캐시에 저장하기 전에 후속 요청이 들어오면 ClickHouse는 같은 집계를 다시 실행했습니다. 이 중복 계산으로 CPU 부하가 높아졌습니다.
ClickHouse 쿼리 캐시는 완료된 결과만 재사용했습니다. 첫 조회가 진행되는 동안 들어온 같은 요청도 하나로 묶으려고 Rill 캐시와 singleflight를 비교했습니다.
집계와 캐시의 효과를 다음 조건으로 비교했습니다.
- 데이터: 합성 이벤트 1,026만 건, 일 집계 245만 행, 월 집계 15만 행
- 환경: 로컬 ClickHouse 4코어, Rill 1대
- 요청: 사용자 10명이 패널 13개를 동시에 열고 3s 뒤 재조회
- 반복: 조회 조건을 바꾸며 4회
| 집계 | ClickHouse 캐시 | Rill 캐시 | 첫 조회 시간 | 재조회 시간 | SELECT 실행 수 | CPU 80% 이상인 시간 | CPU 사용량 (코어·초) |
|---|---|---|---|---|---|---|---|
| 일 집계 | OFF | OFF | 12.3 ~ 13.1s | 12.3 ~ 13s | 1,160 | 92s | 405 |
| 월 집계 | OFF | OFF | 7.6 ~ 7.8s | 7.4 ~ 8.5s | 1,069 | 59s | 252 |
| 월 집계 | ON | OFF | 4.9 ~ 5.5s | 80ms | 214 | 18s | 89 |
| 월 집계 | OFF | ON | 700 ~ 900ms | 60ms | 64 | 0s | 15 |
| 월 집계 | ON | ON | 800 ~ 900ms | 60ms | 64 | 0s | 15 |
- 월 집계만 사용: 읽는 데이터량은 줄었지만 같은 집계는 요청마다 실행됐습니다.
- ClickHouse 캐시: 완료된 결과를 재사용했습니다. 첫 조회가 끝나기 전에 겹친 요청은 각각 실행했습니다.
- Rill 캐시와 singleflight: 진행 중인 같은 요청도 묶었습니다. 이번 시험에서는 CPU 사용률이 80% 이상인 구간이 없었습니다.
- 두 캐시 사용: 대시보드의 SELECT 실행 수와 CPU 사용량은 Rill 캐시만 사용했을 때와 같았습니다.
AI가 만든 SQL의 실행량을 제한하기 위한 쿼리 한도 설정하기
Rill MCP에서는 사용자의 질문에 따라 조회 기간과 조건이 달라졌습니다. AI가 작성한 SQL이 집계 뷰 대신 원본 테이블을 조회하거나 기간 조건 없이 실행되는 경우도 고려해야 했습니다.
사용자가 원하는 분석은 허용하되, SQL 한 번이 읽고 집계하는 데이터량에는 한도가 필요했습니다. 먼저 MCP의 지표 조회와 SQL 직접 조회가 Rill 캐시와 singleflight를 사용하는지, ClickHouse 쿼리 로그의 실행 횟수로 확인했습니다.
| MCP 도구 | 같은 조회 3회 반복 | 같은 조회 10개 동시 |
|---|---|---|
query_metrics_view | 1회 실행 | 1회 실행 |
query_sql | 3회 실행 | 10회 실행 |
- 지표 조회: Rill 캐시와 singleflight를 사용했습니다. 대시보드와 MCP 지표의 캐시는 별도였습니다.
- SQL 직접 조회: Rill 캐시와 singleflight를 거치지 않아 요청마다 실행됐습니다.
SQL 조회는 유지하면서, AI에 전달할 지침과 ClickHouse의 실행 한도를 함께 적용했습니다. 지침을 따르지 않은 SQL에도 한도가 적용되도록 구성했습니다.
- MCP 가드레일:
ai_instructions로 지표 조회를 우선하고, SQL에는 원본 대신 일 집계와 월 집계 뷰를 사용하도록 안내했습니다. - ClickHouse 하우스키핑: 읽기와 자원 사용 한도를 적용하고, 쿼리 캐시로 완료된 같은 조회의 결과를 5분간 재사용했습니다.
| 설정 | 적용값 |
|---|---|
| 쿼리 캐시 | 완료된 결과를 5분간 재사용 |
| 스레드 | 쿼리당 2개 |
| 메모리 | 쿼리당 4GB, 계정 합계 6GB |
| 실행 시간 | 60s |
읽는 행 수 (max_rows_to_read) | 1,000만 행 |
읽는 데이터량 (max_bytes_to_read) | 2GiB |