상황
출시 후 출석 API의 평균 응답 시간은 2 ~ 24ms였지만, 9월 17일 일부 요청은 수백 ms가 걸렸습니다. trace에서는 두 요청 모두 attendance_history 조회 두 번이 시간의 대부분을 차지했고, 결과를 읽는 result-set은 1ms 미만이었습니다.
/v1/pc/challenge/today | /v1/web/challenge/board |
|---|---|
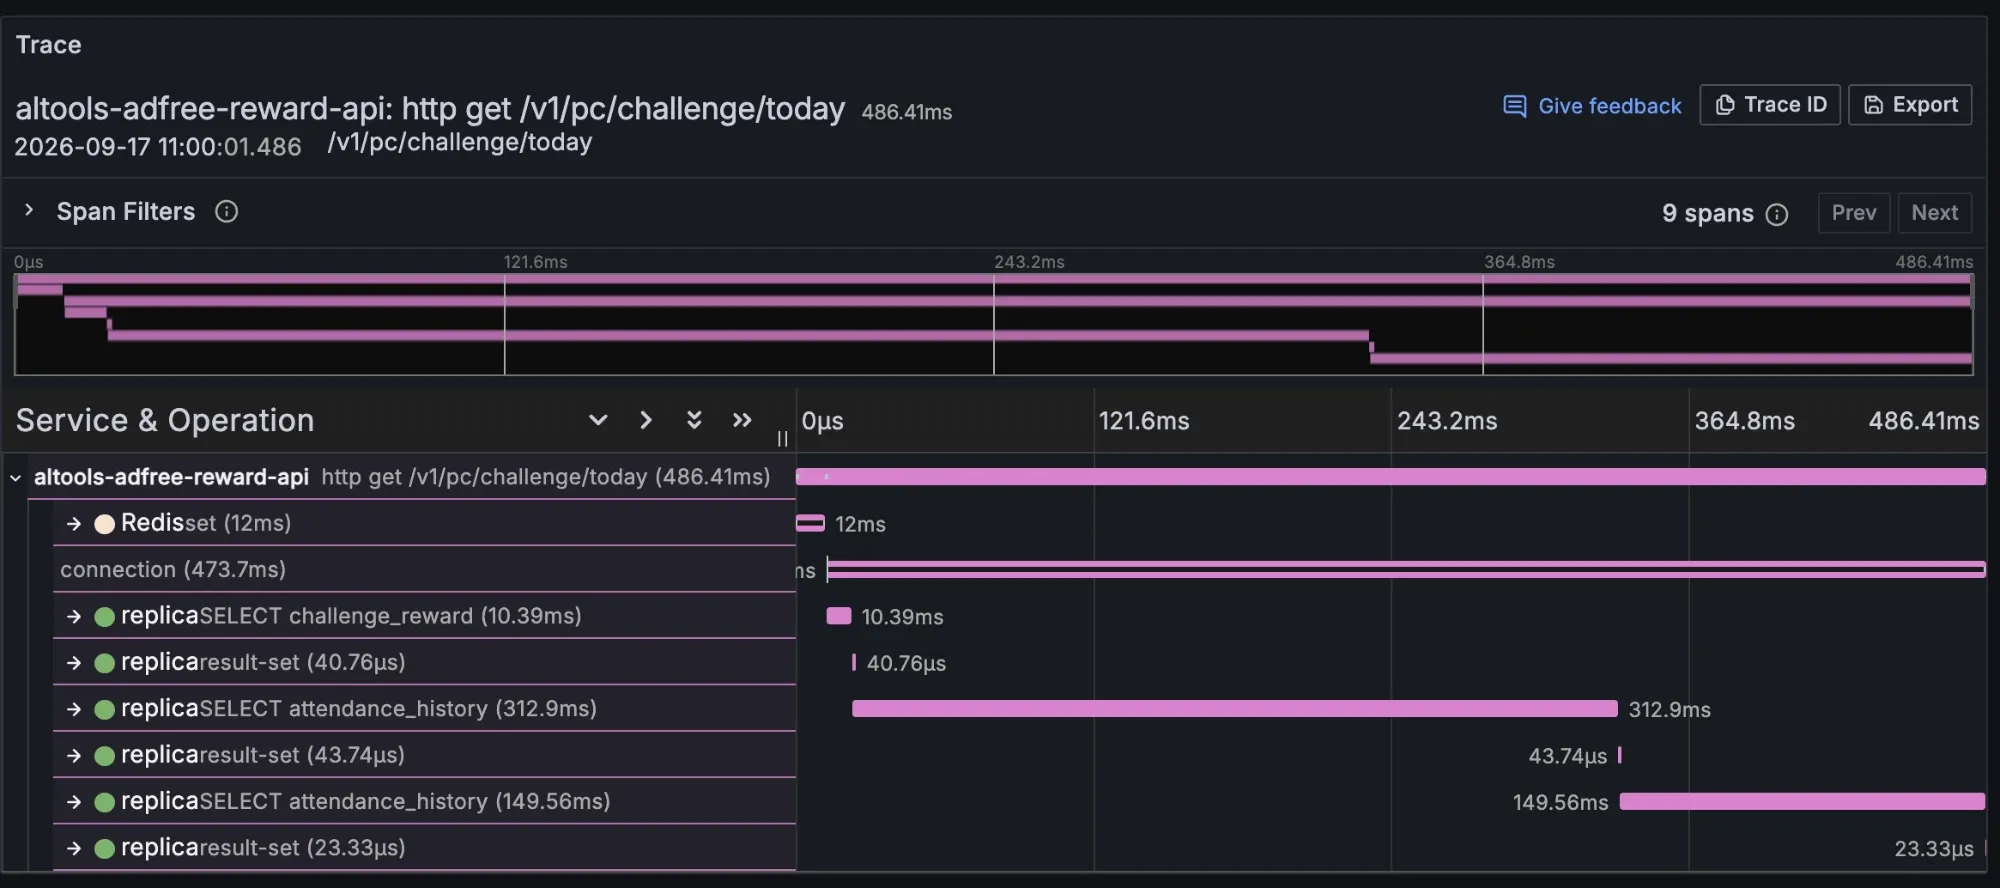 | 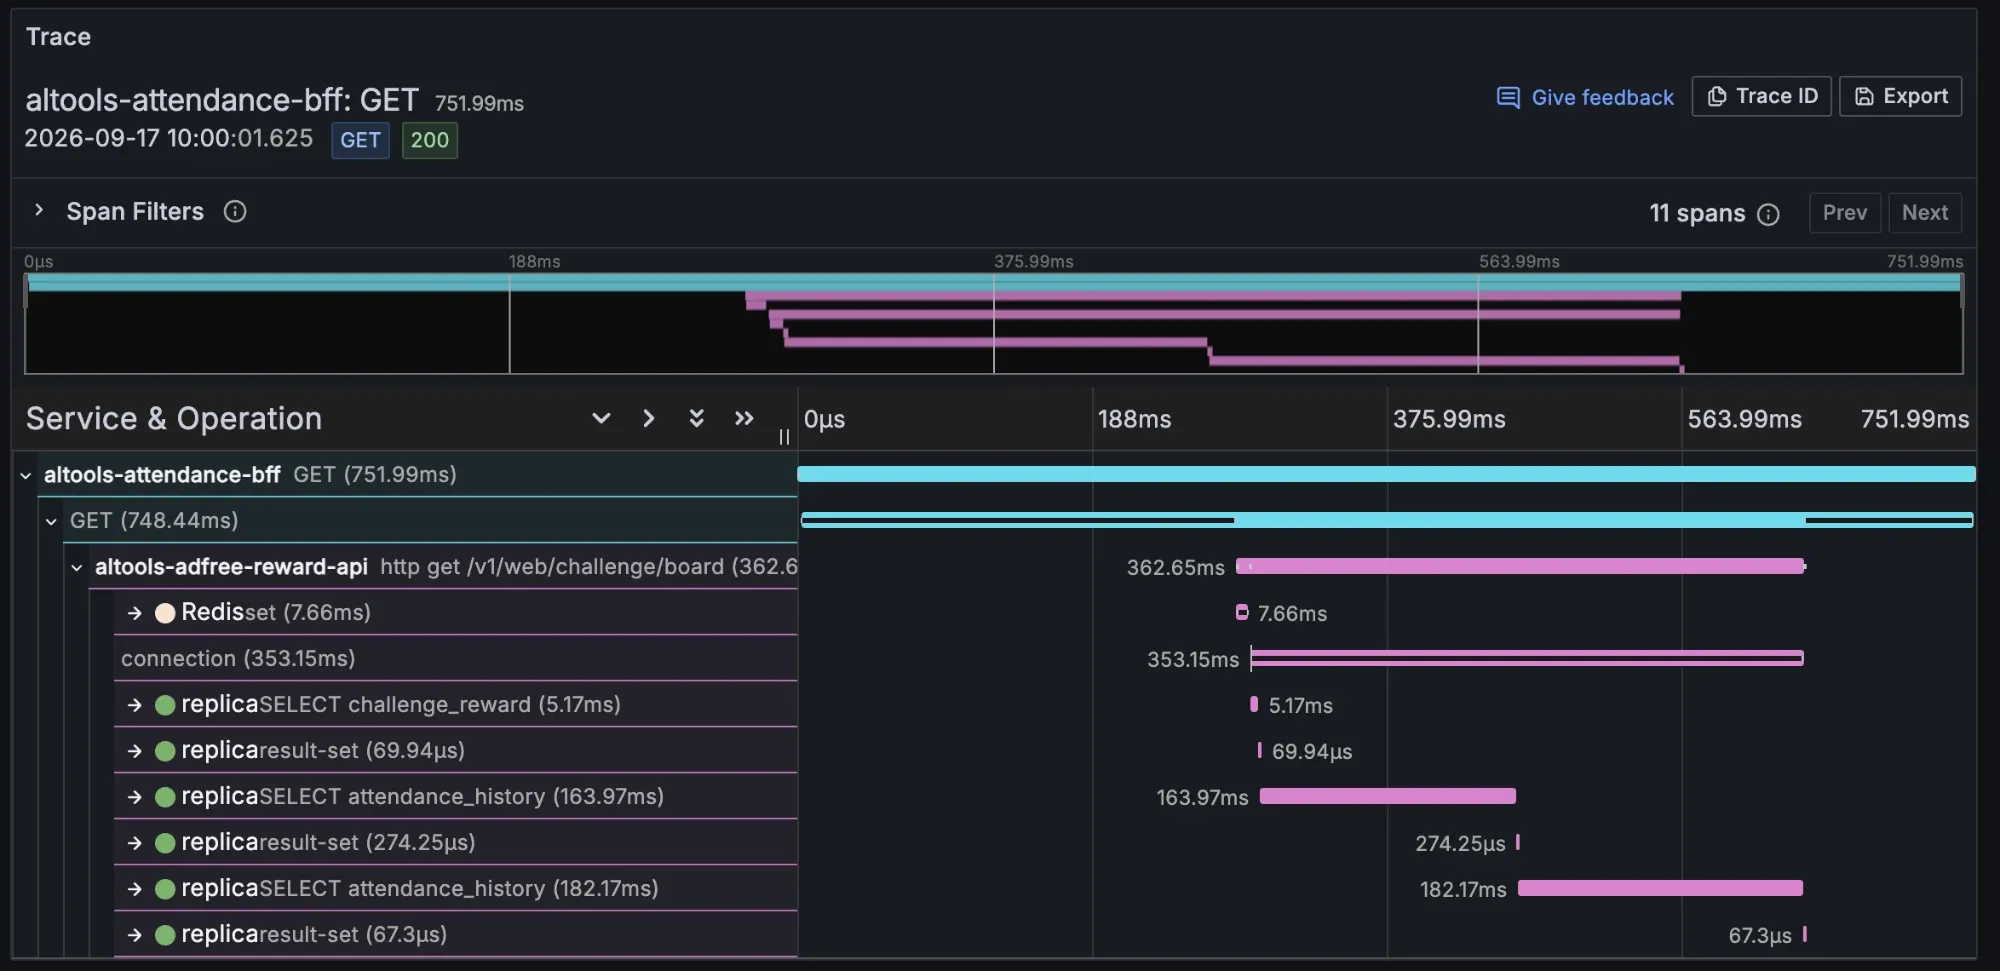 |
|
|
원인
trace로는 어느 SQL이 오래 걸렸는지까지만 알 수 있었습니다.
- JDBC span에는 SQL과 실행 시간만 기록됩니다. MySQL은 옵티마이저가 선택한 실행계획을 JDBC 프로토콜로 전달하지 않습니다.
- span만으로는 다음을 구분할 수 없습니다.
- 동시 요청이 늘어 커넥션을 기다렸는지
- 다른 트랜잭션의 잠금을 기다렸는지
- 실행계획이 평소와 달랐는지
- 문제가 발생한 뒤 같은 SQL을 다시
EXPLAIN하면, 통계 정보, 바인드 값, 데이터 분포가 달라져 그 시점과 다른 실행계획이 나올 수 있습니다.
느린 쿼리의 실행 정보를 남기는 두 방법을 로컬 MySQL 8.4에서 비교했습니다.
- 애플리케이션: datasource-proxy로 실행 시간을 측정하고, 임계값을 넘으면 별도 커넥션으로
EXPLAIN을 실행합니다. - DB: slow log와
performance_schema에 기록되는 쿼리별 실행 정보를 사용하고, 실행 중인 쿼리의 실행계획은EXPLAIN FOR CONNECTION으로 조회합니다.
해결
전제
느린 쿼리의 실행 정보를 뽑는 위치를 두 곳으로 나눠 비교했습니다.
- DB에서 지표 뽑기: MySQL이 스스로 기록하는 slow log와
performance_schema를 사용합니다. 읽은 행 수, 정렬과 임시 테이블의 디스크 기록, 잠금 대기 시간이 남는지 확인합니다. - 애플리케이션에서 지표 뽑기: DB 밖에서
EXPLAIN을 실행해 실행계획을 얻습니다. 실행 중인 쿼리에 대한EXPLAIN FOR CONNECTION의 범위와 제약, 애플리케이션 안에서 직접EXPLAIN을 실행할 때의 커넥션 풀 영향을 확인합니다.
실험 조건
어제 낙서장의 합성 횟수 원장 300만 행에 인덱스가 없는 note 컬럼을 추가했습니다. 코드와 측정값은 실험 디렉터리에 있습니다.
- 환경
- MySQL 8.4.11 Docker, CPU 4개, 메모리 3GiB
- Buffer Pool 1,152MiB, Binary Log 비활성화
- 로그와 performance_schema 설정
long_query_time=0.5log_slow_extra=ON- consumer
events_statements_history_long=ON,events_statements_cpu=ON
- 재현용 설정. 정렬과 임시 테이블이 디스크에 기록되는 조건을 만들기 위한 값이며 운영 권장값이 아닙니다.
sort_buffer_size=32768temptable_max_ram=2097152temptable_max_mmap=0
- 주석: 모든 쿼리 앞에
/* traceId=... */를 붙여 slow log,performance_schema,threads에서 같은 쿼리를 찾았습니다.
| 이름 | 쿼리 | 재현하려는 조건 |
|---|---|---|
index_lookup | 사용자, 기능, 시각 범위로 COUNT(*) | 일일 횟수 조회, 인덱스 탐색 |
full_scan | note LIKE '%7f%' 조건의 COUNT(*) | 인덱스 없는 컬럼의 전체 스캔 |
full_join_no_index | 인덱스 없는 feature_dim과 조인 후 GROUP BY f.name | 인덱스 없는 조인과 디스크 임시 테이블 |
sort_spill | note 정렬 후 100만 행 파생 테이블의 COUNT(*) | 정렬 버퍼 초과 |
scan_group | note LIKE 조건과 GROUP BY user_id, 상위 10건 | 스캔과 집계, watchdog 대상 |
DB에서 지표 뽑기: slow log와 performance_schema의 실행 통계
log_slow_extra를 켜면 slow log 항목에 스토리지 엔진 핸들러 호출 횟수와 정렬, 임시 테이블 카운터가 추가됩니다. 같은 값이 events_statements_history_long에 쿼리 단위로 기록됩니다. (MySQL slow log 문서)
# Time: 2026-09-22T02:39:45.836571Z
# User@Host: root[root] @ localhost []  Id:    23
# Query_time: 3.014766  Lock_time: 0.000002 Rows_sent: 20  Rows_examined: 3000020
# Thread_id: 23 Errno: 0 Killed: 0 Bytes_received: 155 Bytes_sent: 532
# Read_first: 3 Read_last: 0 Read_key: 3000004 Read_next: 3000000 Read_prev: 0 Read_rnd: 0 Read_rnd_next: 63
# Sort_merge_passes: 0 Sort_range_count: 0 Sort_rows: 0 Sort_scan_count: 0
# Created_tmp_disk_tables: 1 Created_tmp_tables: 1
SELECT /* traceId=p1-full_join_no_index-1 */ f.name, COUNT(*) FROM feature_dim f JOIN usage_history h ON h.feature_id = f.feature_id GROUP BY f.name;slow.log
표의 시간은 3회 중앙값이고, 카운터는 3회 모두 같았습니다.
| 쿼리 | TIMER_WAIT (ms) | CPU_TIME (ms) | Rows_examined | Rows_sent |
|---|---|---|---|---|
index_lookup | 0.1 | 0.1 | 0 | 1 |
full_scan | 477.3 | 477.3 | 3,000,000 | 1 |
full_join_no_index | 3,023.4 | 3,022.8 | 3,000,020 | 20 |
sort_spill | 1,471.0 | 1,265.0 | 1,000,000 | 1 |
scan_group | 3,528.0 | 3,527.7 | 3,000,010 | 10 |
| 쿼리 | Read_key | Read_next | Read_rnd_next | Sort_merge_passes | 디스크 임시 테이블 |
|---|---|---|---|---|---|
full_join_no_index | 3,000,004 | 3,000,000 | 63 | 0 | 1 |
sort_spill | 2 | 0 | 4,020,027 | 2,058 | 1 |
scan_group | 1 | 3,000,000 | 0 | 0 | 0 |
full_join_no_index:Read_key3,000,004는GROUP BY임시 테이블 조회 횟수입니다.GROUP BY를 빼면 2로 줄었습니다. 인덱스 없는 조인은SELECT_FULL_JOIN=1로 기록됩니다.sort_spill: 정렬 버퍼 초과는Sort_merge_passes2,058로 기록됩니다.TIMER_WAIT와CPU_TIME의 차이가 대기 시간입니다.scan_group:NO_INDEX_USED=0이지만 인덱스 전체를 읽어 300만 행 중 10행을 반환했습니다.
traceId 주석은 DIGEST_TEXT에서만 제거됩니다. digest 통계는 같은 쿼리로 합산되고, 개별 실행은 slow log와 history_long의 SQL_TEXT에서 주석으로 찾을 수 있습니다.
slow log를 log_output=FILE,TABLE로 파일과 테이블에 함께 기록하면 mysql.slow_log를 읽는 Grafana 대시보드 MySQL Slow queries로도 볼 수 있습니다. sql_query에 traceId 주석이 그대로 보입니다.
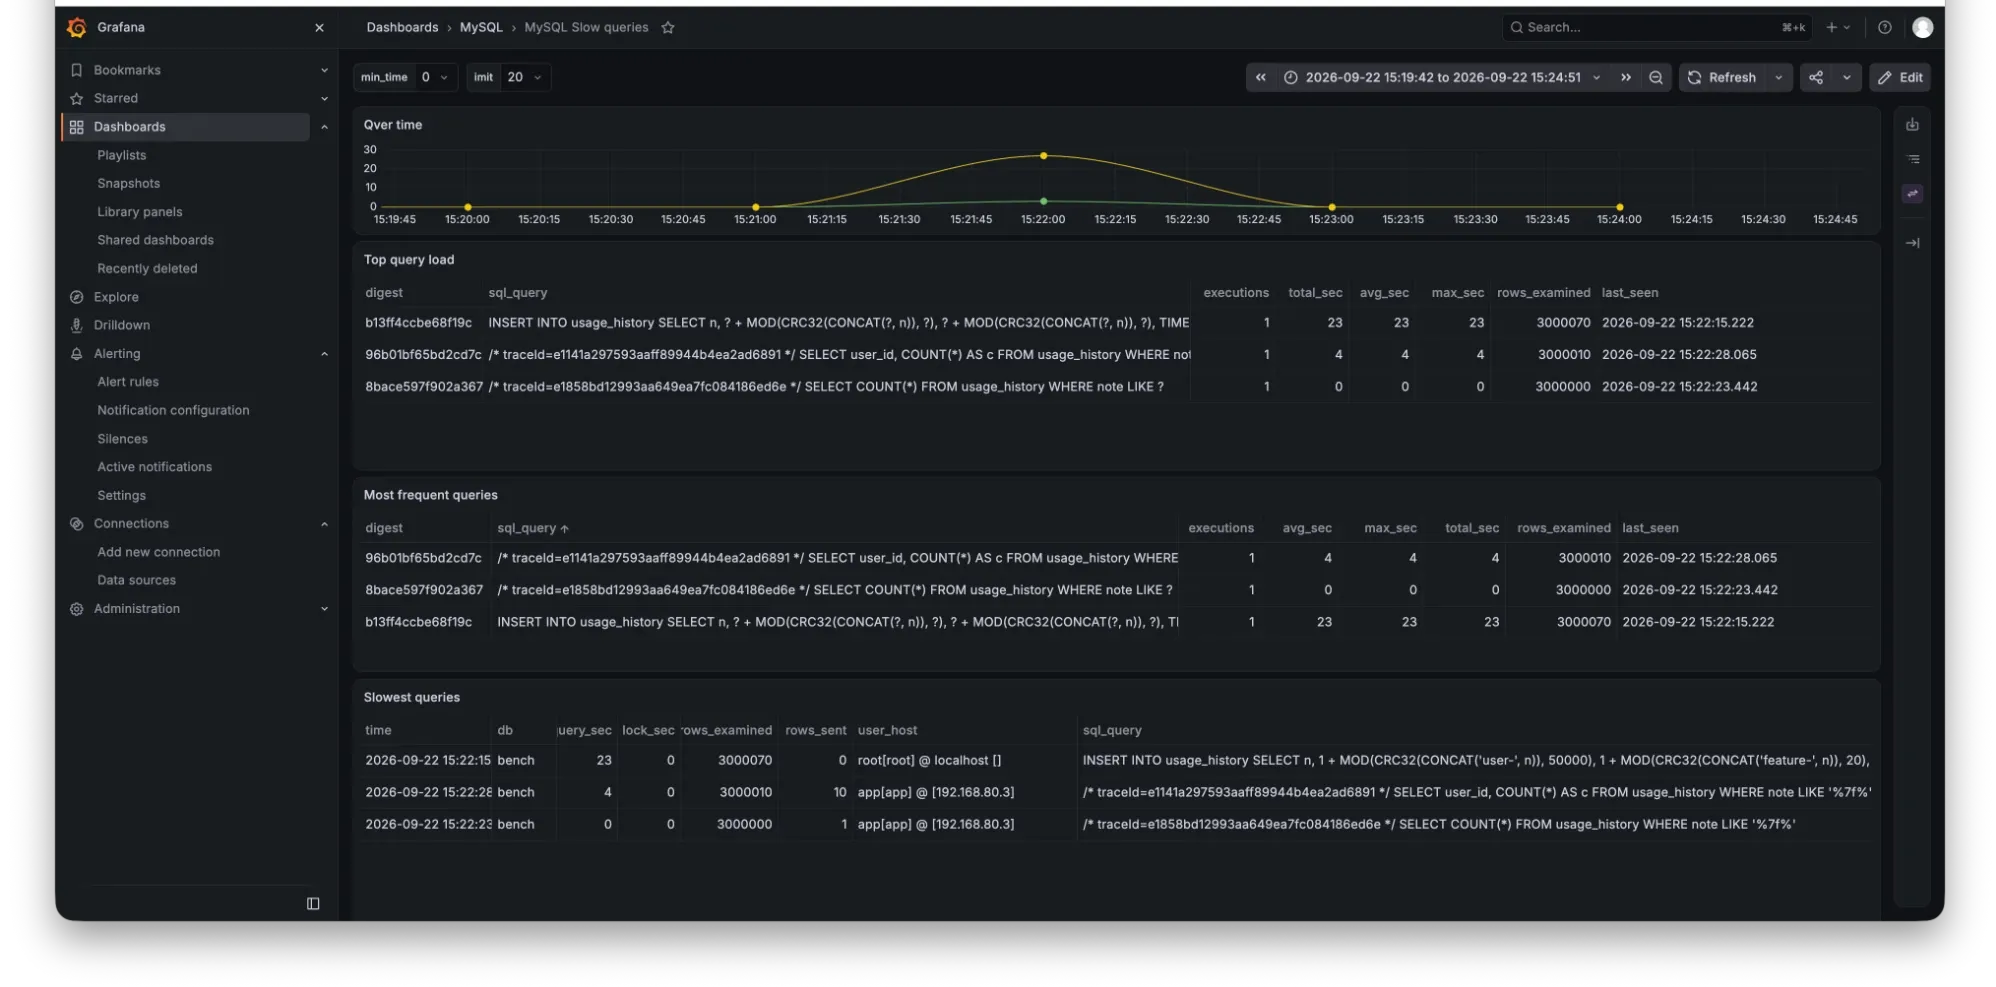
잠금 대기도 확인했습니다. 100만 행 테이블에서 A 트랜잭션이 잠금을 3초 동안 보유할 때, B 트랜잭션의 쿼리가 어떻게 기록되는지 봤습니다. 시간은 performance_schema의 TIMER_WAIT와 LOCK_TIME입니다.
- 행 잠금: A가
UPDATE한 행을 B가UPDATE - 메타데이터 잠금: A가 조회한 테이블에
ALTER TABLE이 대기하는 동안 B가 같은 테이블을 조회
| 잠금 | B 트랜잭션 | TIMER_WAIT (ms) | LOCK_TIME (ms) | threads 상태 |
|---|---|---|---|---|
| 행 잠금 | 같은 행 UPDATE | 2,470.9 | 2,470.6 | updating |
| 메타데이터 잠금 | index_lookup SELECT | 2,160.0 | 0.002 | Waiting for table metadata lock |
- 잠금을 보유한 A 트랜잭션은 행 잠금이면
sys.innodb_lock_waits, 메타데이터 잠금이면sys.schema_table_lock_waits에서 확인합니다. - 대기 중인 B 트랜잭션의 실행계획은
EXPLAIN FOR CONNECTION으로 얻지 못했습니다.
애플리케이션에서 지표 뽑기: EXPLAIN으로 실행 중인 쿼리의 실행계획 조회
EXPLAIN FOR CONNECTION은 다른 세션이 실행 중인 쿼리의 실행계획을 반환합니다. 절차는 다음과 같습니다.
scan_group을 별도 세션에서 실행합니다.- watchdog이 100ms 간격으로
performance_schema.threads에서PROCESSLIST_TIME >= 1인 세션을 찾습니다. - 찾은 세션에 TREE, JSON, 기본 형식을 순서대로 실행합니다. (MySQL 문서)
| 회차 | Detection latency (ms) | TREE (ms) | JSON (ms) | 기본 형식 (ms) | 쿼리 전체 (ms) |
|---|---|---|---|---|---|
| 1 | 229.7 | 53.2 | 48.1 | 66.4 | 3,590.2 |
| 2 | 387.0 | 62.8 | 60.1 | 51.5 | 3,604.7 |
| 3 | 719.6 | 57.4 | 50.3 | 49.5 | 3,599.2 |
표의 시간에는 docker exec와 mysql 클라이언트 시작 시간 약 50ms가 포함되며, EXPLAIN FOR CONNECTION 자체는 수 ms 이내입니다.
실행 중에 TREE 형식으로 조회한 실행계획은 재실행 결과와 접근 경로가 같았지만 cost와 Filter의 추정 행 수가 달랐고, JSON 형식은 재실행 결과와 같았습니다.
-- EXPLAIN FORMAT=TREE FOR CONNECTION (실행 중)
-> Filter: (usage_history.note like '%7f%')  (cost=4.98e+6 rows=2.91e+6)
-- EXPLAIN FORMAT=TREE (종료 후 재실행)
-> Filter: (usage_history.note like '%7f%')  (cost=295566 rows=322794)
EXPLAIN FOR CONNECTION은 다시 최적화하지 않고 실행 중인 쿼리의 access path 트리에 저장된 값을 출력합니다. TREE 형식은 그 트리의 값을, JSON 형식은 옵티마이저가 filter_effect를 적용한 행 수를 보여줍니다. (opt_explain.cc, sql_executor.cc) 그래서 실행계획은 JSON 형식으로 저장하고, 접근 경로는 TREE 형식으로 읽습니다.
EXPLAIN FOR CONNECTION이 동작하지 않는 조건입니다.
| 조건 | 결과 |
|---|---|
| 쿼리가 끝나고 세션이 종료된 뒤, 또는 없는 id | ERROR 1094 Unknown thread id |
| 쿼리를 실행하지 않는 유휴 세션 | 빈 결과, 오류 없음 |
PREPARE와 EXECUTE, Connector/J useServerPrepStmts=true | ERROR 3012 |
Connector/J useServerPrepStmts=false(기본값) | TREE 실행계획 반환 |
Spring Boot의 Connector/J 기본값은 클라이언트측 prepare라 동작합니다. 다른 사용자의 세션을 조회하려면 MySQL 8.4.11에서는 PROCESS가 아니라 GRANT OPTION을 뺀 모든 전역 권한이 필요했습니다. PROCESS만 가진 계정은 ERROR 1045를 받았고, 같은 사용자 이름으로 접속하면 추가 권한 없이 조회할 수 있습니다. (opt_explain.cc)
watchdog이 캡처한 실행계획을 파일과 함께 evidence.plan_capture 테이블에 저장하면, Grafana에서 slow log와 같은 MySQL 데이터 소스로 볼 수 있습니다. 위 패널은 watchdog 캡처, 아래 패널은 같은 traceId의 performance_schema 실행 통계입니다.
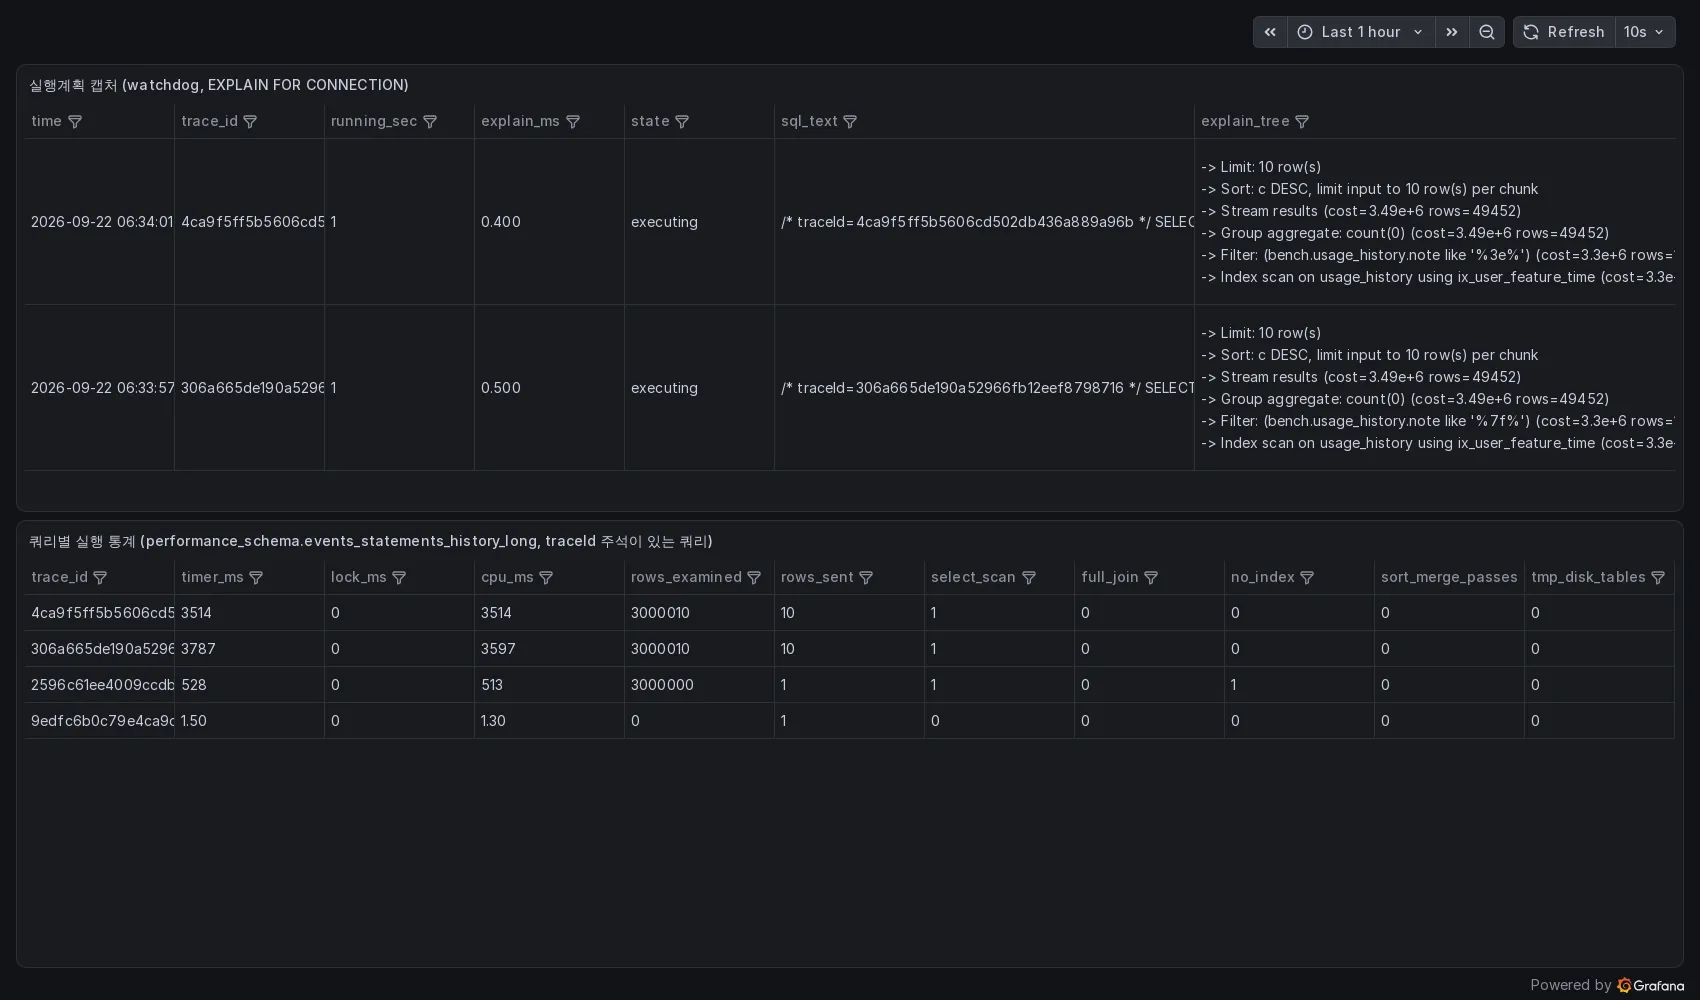
애플리케이션에서 직접 EXPLAIN을 실행하는 방식과도 비교했습니다. HikariCP 6.3.0 풀(maximumPoolSize=10, connectionTimeout=2000)에 전체 스캔 스레드 12개와 인덱스 조회 스레드 4개를 40초 동안 실행하고, datasource-proxy 리스너에서 EXPLAIN을 실행하는 구조를 두 가지로 재현했습니다.
same_pool_sync: 전체 스캔이 끝난 직후 같은 스레드에서 같은 풀의 두 번째 커넥션을 얻어EXPLAIN을 실행합니다. 요청 커넥션은 아직 반납 전입니다.separate_pool_async: SQL을 큐에 넣고, 전용 커넥션 1개를 쓰는 워커가EXPLAIN을 실행합니다.
| 모드 | 인덱스 조회 성공 | 풀 시간 초과 | p50 (ms) | p95 (ms) | 전체 스캔 성공 |
|---|---|---|---|---|---|
baseline | 258 | 0 | 273.6 | 1,554.4 | 242 |
same_pool_sync | 34 | 58 | 1,569.6 | 1,687.4 | 120 |
separate_pool_async | 249 | 1 | 571.3 | 1,394.6 | 248 |
same_pool_sync에서는 인덱스 조회 92건 중 58건이 실패했습니다. 캡처가 두 번째 커넥션을 기다린 시간이 p50 1,928.0ms였고, 그동안 요청 커넥션도 반납되지 않아 풀 대기 스레드가 6개에서 16개로 늘었습니다.separate_pool_async는baseline과 같은 수준이었습니다. 인덱스 조회 실패는 1건이었고, 캡처 248회는 전용 커넥션을 최대 2.4ms 안에 얻었습니다.
전체 스캔 스레드를 8개로 줄여 커넥션이 남는 조건에서는 세 모드 모두 인덱스 조회 실패가 없었습니다.
실행계획을 애플리케이션 쪽에서 뽑는 방법은 두 가지이고, 둘 중 하나를 선택합니다.
| 항목 | datasource-proxy 비동기 캡처 | watchdog |
|---|---|---|
| 잡는 쿼리 | 임계값을 넘은 모든 쿼리 | 1초 이상 실행 중인 쿼리 |
| 실행계획 | 쿼리가 끝난 뒤 재실행한 계획 | 실행 중이던 계획 |
| 실행 위치 | 앱 안의 전용 풀 1개와 큐 | 별도 프로세스 |
| DB 계정 | 앱 계정 | 앱 계정, 또는 모든 전역 권한 |
| 파라미터, traceId | 리스너가 바인드 값과 traceId를 직접 받음 | PROCESSLIST_INFO에서 파싱 |
결과
두 방식의 장단점입니다.
| 방식 | 장점 | 단점 |
|---|---|---|
| DB에서 지표 뽑기 |
|
|
| 애플리케이션에서 지표 뽑기 |
|
|
지표별로 기록되는 곳입니다. 비어 있는 칸은 그쪽에서 얻을 수 없다는 뜻입니다.
| 지표 | DB | 애플리케이션 |
|---|---|---|
| 읽은 행 수 | Rows_examined | - |
| 정렬 버퍼 초과 | Sort_merge_passes | - |
| 디스크 임시 테이블 | Created_tmp_disk_tables | - |
| 행 잠금 대기 | LOCK_TIME | - |
| 메타데이터 잠금 대기 | 대기 중 threads 상태 | - |
| 실행계획 | - | datasource-proxy 비동기 캡처 또는 watchdog |
| 커넥션 대기 | - | JDBC span, HikariCP 메트릭 |
이 기준으로 정리한 구성입니다. docker compose로 만든 코드는 slow-query-evidence 저장소에 있습니다.
- 애플리케이션: datasource-proxy로 SQL 주석에 traceId를 넣고 JDBC span을 기록합니다. 요청 스레드에서는
EXPLAIN을 실행하지 않습니다. - DB
log_slow_extra를 켠 slow log를 파일로 기록해 로그 저장소로 전송합니다.- consumer
events_statements_history_long과events_statements_cpu를 켭니다. - 잠금 대기는
Lock_time,threads상태,data_lock_waits,metadata_locks를 함께 확인합니다.
- 실행계획. 둘 중 하나를 선택합니다.
- datasource-proxy 리스너가 임계값을 넘은 SQL을 큐에 넣고, 전용 풀 1개를 쓰는 워커가
EXPLAIN을 실행해 저장합니다. - watchdog이 별도 프로세스에서
threads를 폴링해 실행 중인 쿼리에EXPLAIN FOR CONNECTION을 실행해 저장합니다. 같은 세션의 같은 쿼리는 한 번만 캡처하고 분당 상한을 둡니다.
- datasource-proxy 리스너가 임계값을 넘은 SQL을 큐에 넣고, 전용 풀 1개를 쓰는 워커가
- 연결: JDBC span, slow log 항목,
history_long행, 저장한 실행계획을 traceId로 연결합니다.
남은 확인 사항입니다.
- 통계 갱신이나 데이터 분포 변화로 실행계획이 바뀌는 상황을 재현해,
FOR CONNECTION으로 조회한 실행계획이 재실행 결과와 다른 경우를 확인합니다. - 운영 서비스의 JDBC URL에서
useServerPrepStmts설정을 확인합니다. history_long링 버퍼(기본 1만 건)가 운영 부하에서 덮어써지는 속도와 slow log 파일 전송 지연을 확인합니다.